Juste au moment de la sortie de GPT-5.5, Claude l'a finalement admis :
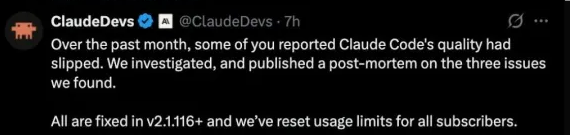
Oui, le modèle est devenu “ moins performant ”, et tous les quotas d'utilisation ont été réinitialisés.
Après plus d'un mois de démentis, l'information confidentielle a finalement été révélée directement par Anthropique lui-même :
- Le niveau de raisonnement a été discrètement revu à la baisse, passant de “ élevé ” à “ moyen ”
- Un bug de mise en cache effaçait les traces de réflexion à chaque tour
- La limite de 25 mots imposée à la consigne a nui à la qualité du résultat
Si l'on additionne ces trois bugs, l'expérience globale de Claude en a sérieusement pâti.
Heureusement que les concurrents ont mis la pression au bon moment. Tenter de “ sensibiliser les utilisateurs ” n'allait manifestement pas fonctionner.
Cela dit, corriger des bugs est toujours une bonne chose. C’est juste que… le moment choisi est suspect. À peine le GPT-5.5 est-il sorti que, tout à coup, Claude “ reconnaît sa défaite ”.”
La version 5.5 a-t-elle facilité le débogage ?
Dario… tu n’as tout de même pas fait exprès d’aggraver la situation de Claude juste pour préparer un retour en force à l’occasion du lancement de GPT-5.5, n’est-ce pas ?
Trois bugs confirmés à l'origine de la baisse de performances de Claude
Tout d'abord, ce n'est pas la première fois.
En août dernier, Anthropic avait publié une analyse rétrospective similaire concernant les versions 4.0 et 4.1 d'Opus, dans laquelle l'entreprise précisait également : “ Nous n'avons jamais eu l'intention de réduire la qualité du modèle. ”
Cette fois-ci, la nouvelle analyse rétrospective s'intitule “ Une analyse rétrospective de trois numéros récents. ”
“Le terme ” récent » est essentiel : il ne s'agit pas seulement du moment présent, mais de la période écoulée.
La communauté l'avait déjà remarqué
L'aggravation de l'état de santé de Claude faisait l'objet de nombreuses discussions depuis un certain temps déjà.
Il y a plus de dix jours, Stella Laurenzo, directrice senior du département IA chez AMD, a publié un audit approfondi sur GitHub :
- 6 852 conversations
- 17 871 blocs de raisonnement
- Plus de 230 000 appels de fonction
Les conclusions : depuis février, la profondeur du raisonnement a fortement diminué.
Observations plus détaillées :
- Claude a commencé à sombrer dans boucles de raisonnement
- Elle a de plus en plus opté pour le la solution la plus simple, ce n'est pas le bon
Par ailleurs, le test de performance BridgeBench de BridgeMind a montré que Opus 4.6 précision passant de 83,31 TP3T à 68,31 TP3T, et classement passant de #2 à #10.
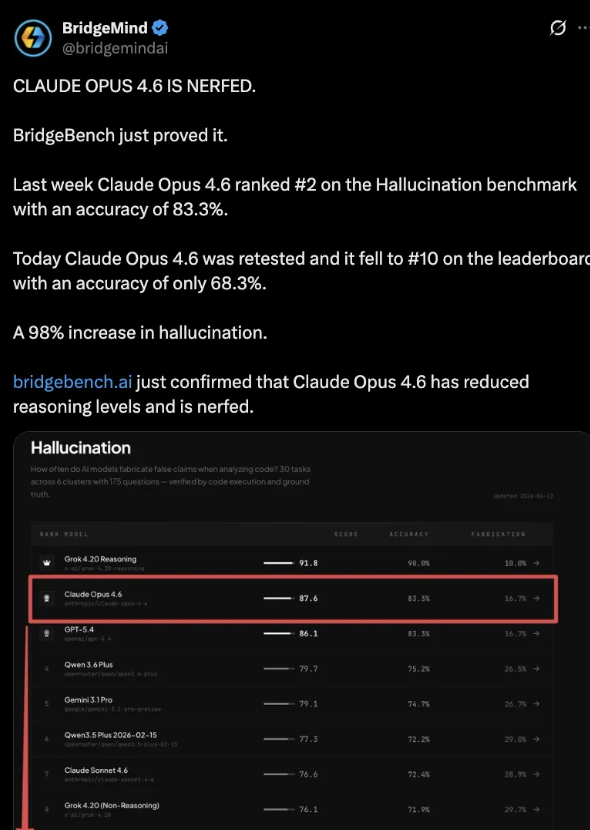
Même si cette méthodologie a ensuite fait l'objet de critiques, cette version des faits s'est imposée :
Claude devient de plus en plus bête.
Les gens ont même inventé un terme — « Shrinkflation » liée à l'IA. Même prix, produit dilué.
En d'autres termes, les utilisateurs avaient l'impression de se voir proposer un “ menu enfant ’.”
Explication des trois bugs
Baisse imperceptible du niveau de raisonnement
Le 4 mars, la défaillance de Claude Code niveau de raisonnement a été ramené de “ élevé ” à “ moyen ” en raison de problèmes de latence.
Mais l'interface utilisateur affichait toujours “ élevé ”.”
Les utilisateurs pensaient disposer de la pleine puissance, mais se sont en réalité retrouvés avec une version allégée.
Cette mesure a duré plus d'un mois avant d'être annulée.
Plus on discute, plus ça devient stupide
Le 26 mars, une optimisation de la mise en cache a été mise en place :
- Objectif : effacer les anciens raisonnements après 1 heure d'inactivité
- Réalité : à cause d'un bug, il s'est effacé à chaque tour
Résultat :
- Claude a continué à travailler, mais a perdu de vue ses propres objectifs
- Symptômes : perte de mémoire, répétitions, utilisation chaotique des outils
Pire encore :
Comme le raisonnement était constamment effacé, le cache n'était jamais utilisé → la consommation de jetons a explosé.
Il a fallu 15 jours pour réparer ça.
Une seule ligne de commande a compromis la qualité de sortie
Le 16 avril, une consigne système a été ajoutée :
- 25 mots maximum entre chaque appel d'outil
- Réponse finale limitée à 100 mots
Impact :
- Opus 4.6 et 4.7 les deux ont enregistré une baisse de performances d'environ 31 TP3T
- Rétrogradé au bout de 4 jours
Avril : une série de problèmes dont on est soi-même responsable
Si l'on examine la chronologie des événements, le mois d'avril n'a pas seulement été marqué par des bugs : il a également été le théâtre d'une série de décisions discutables.
4 avril — Blocage des outils tiers
Anthropic a bloqué des outils tels que OpenClaw liés à l'utilisation des abonnements Pro/Max.
Vous souhaitez continuer à les utiliser ? Passez à la facturation par API.
21 avril — Modifications discrètes des tarifs
Claude Code a été supprimé depuis la page du forfait Pro.
Les documents d'aide ont été modifiés à partir de :
- “ Pro ou Max ” → “ Max uniquement ”
Suite à la polémique, Amol Avasare, responsable de la croissance, a affirmé qu'il ne s'agissait que d'un test A/B « 2% ».
Problème : la modification a concerné l'ensemble du site.
La mesure a été annulée en l'espace de quelques heures.
La réalité des prix
- Pro : $20/mois → $240/an
- Max. 5x : $100/mois → $1200/an (multiplié par 5)
- Max. 20x : 1 TP 4 T 2 400/an (multiplication par 10)
Pas de niveau intermédiaire.
23 avril — Bilan rétrospectif et “ indemnisation ”
La compensation ? Une réinitialisation des quotas d'utilisation.
Certains utilisateurs ont fait remarquer :
Cela s'était déjà produit lors de la sortie de la version Opus 4.7.
Cette “ compensation ” n'était donc en fait rien d'autre qu'une simple réinitialisation du cycle.
Les utilisateurs n'y croient pas
Les avis sont partagés.
Certains disent :
- Des bugs, ça arrive
- L'analyse rétrospective est transparente
- Boris Cherny a réagi activement sur Hacker News
D'autres se concentrent sur une autre question :
Deux mois de silence
- Aucune communication officielle
- Seules quelques réponses éparses sur X
- Manque de cohérence dans la communication
Soupçons concernant l“” optimisation du cache »
Certains estiment que le moment choisi (qui coïncide avec l'expiration du cache) laisse penser que :
Il ne s'agit pas d'optimiser la latence, mais de réduire les coûts.
La polémique autour des tests A/B
Différents utilisateurs ont reçu, sans en être informés, des configurations de produit différentes.
La confiance a subi un nouveau coup dur.
La migration est déjà en cours
Une tendance intéressante sur Hacker News :
Des personnes qui racontent leurs “ histoires de migration ”.”
Certains ont déclaré avoir inconsciemment opté pour Codex en février dernier — et ce n'est que maintenant qu'ils se rendent compte que le déclin de Claude a peut-être été le facteur déclencheur.
D'autres affirment que GPT-5.4 surpasse déjà Opus 4.6.
Certains prennent des compléments alimentaires MiniMax :
- $40 → 4 500 messages par cycle de 5 heures
- Visibilité totale du raisonnement
Le paysage a changé
Il y a six mois, l’idée selon laquelle “ il fallait utiliser Claude pour le codage ” faisait l’objet d’un quasi-consensus.
Maintenant :
- Codex compterait 4 millions d'utilisateurs actifs
- GPT-5.5 se concentre sur la programmation et l'utilisation des ordinateurs
- Les collaborateurs d'OpenAI le décrivent même comme un modèle de “ chef de cabinet ”
L'état de Claude ne s'est pas forcément aggravé.
D'autres se sont améliorés… et Claude a trébuché au pire moment qui soit.
La fenêtre rétrécit
Anthropic dispose désormais de moins de temps qu'auparavant pour :
- Corriger les bugs
- Rétablir la confiance
En attendant :
- GPT-5.5 est déjà disponible
- DeepSeek V4 est prêt
Et les gens attendent :
Gémeaux, à toi de jouer.