Claude Opus 4.7 reprend la tête des classements dans les tests de performance en IA
Cette semaine, Anthropique Sortie de Claude Opus 4.7.
Elle a retrouvé la première place dans deux des indices de référence publics les plus suivis.
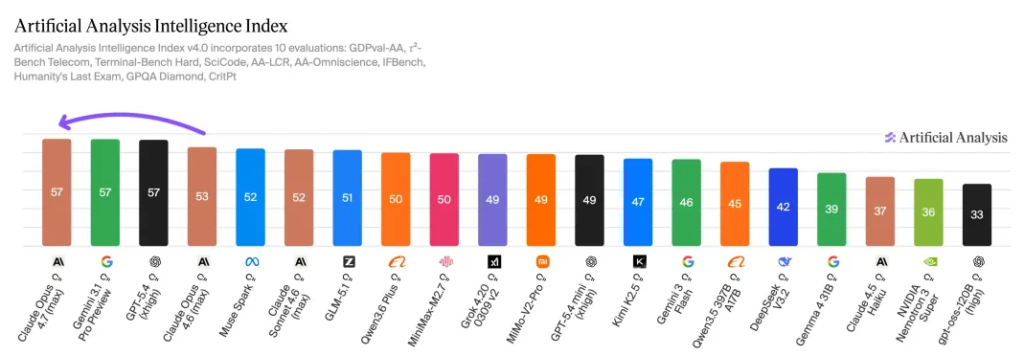
Dans le classement général d'Artificial Analysis consacré à l'intelligence, Opus 4.7 a obtenu un score de 57, contre 53 pour Opus 4.6, ce qui le place sans conteste parmi les meilleurs.
D’après les derniers résultats de Code Arena publiés par Arena.ai, Opus 4.7 s’est classé en tête avec un score de 1 583, soit 34 points de plus qu’Opus 4.6 Thinking, qui a obtenu 1 549 points. Il a également devancé de loin le modèle non-Anthropic le plus proche et s'est classé premier dans les sous-catégories React et HTML.
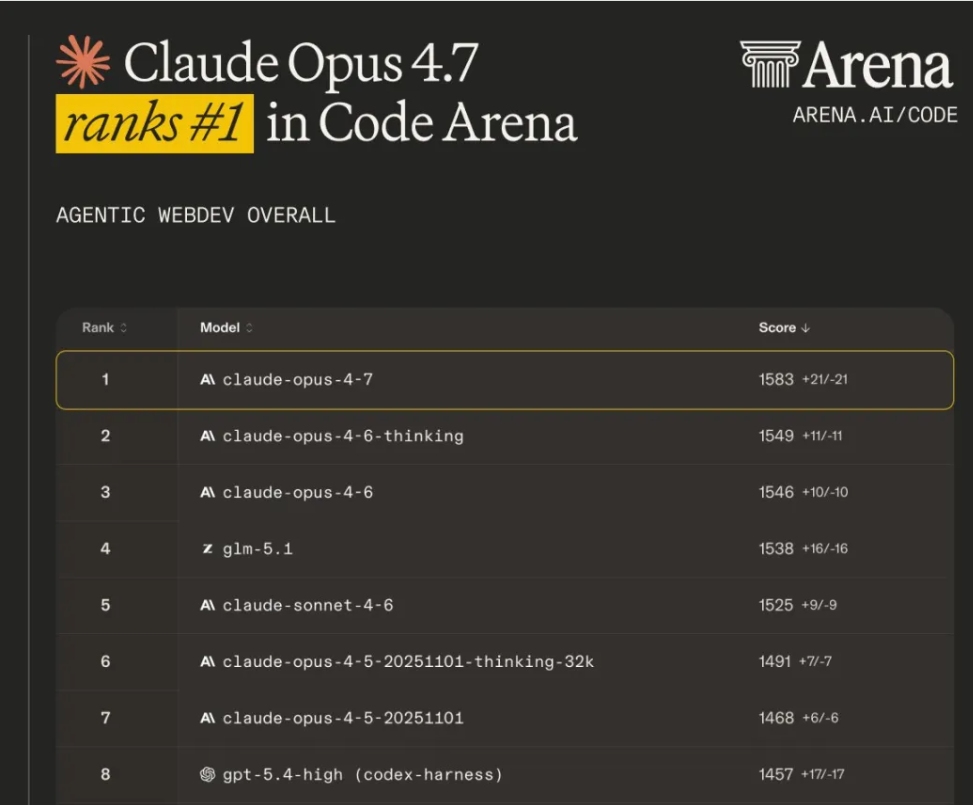
Résultats des tests de performance : comparaison entre Claude Opus 4.7 et Opus 4.6
L'importance de cette nouvelle série de classements tient moins d'une avancée majeure que d'un rééquilibrage du marché.
Au cours des deux dernières années, le secteur des grands modèles s'est acharné à repousser les limites de leurs capacités : qui dispose du plus grand nombre de paramètres, qui est capable de raisonner plus longtemps, qui propose les meilleures démonstrations, qui se rapproche le plus de cet idéal toujours aussi lointain AGI.
Pourquoi les besoins des entreprises en matière d'IA évoluent en 2026
Mais d'ici 2026, les critères des entreprises clientes auront évolué.
On se demande moins quel modèle est le plus polyvalent, et davantage ce qui est bien plus concret :
Peut-on le connecter à des systèmes ?
Peut-il s'intégrer dans les flux de travail ?
Est-ce qu’il permet d’accomplir cette tâche de manière fiable ?
Les améliorations apportées aux partitions dans Opus 4.7 s'inscrivent parfaitement dans cette nouvelle norme.
Claude Opus 4.7 : gains de performances dans les flux de travail concrets
Les indicateurs publiés par Anthropic vont tous dans la même direction.
Sur 93 tests de référence internes en matière de codage, Opus 4.7 a amélioré les taux d'achèvement des tâches de 13% par rapport à Opus 4.6.
Sur CursorBench, les performances sont passées de 581 TP3T à 701 TP3T.
Lors des tests menés par Notion sur des flux de travail en plusieurs étapes, l'efficacité globale a progressé de 14%, tandis que les erreurs liées à l'appel des outils ont été réduites à un tiers de leur niveau antérieur.
Même les retours des clients d’Anthropic mettent en évidence les mêmes thèmes :
l'autonomie, moins d'erreurs et la capacité à persévérer même lorsque les outils font défaut.
Pris isolément, aucun de ces chiffres ne semble alarmant. Mais pris dans leur ensemble, ils en disent long.
Du chat à l'exécution : l'évolution vers l'IA appliquée aux flux de travail
Les améliorations apportées à Opus 4.7 portent principalement sur les fonctionnalités les plus difficiles à mettre à l'échelle — et les plus déterminantes sur le plan commercial — : l'exécution de tâches de longue durée, la coordination en plusieurs étapes, la fiabilité des outils et la prudence en cas d'informations incomplètes.
Les systèmes de réponse à une question en un seul échange commencent à donner l'impression d'être un simple effet de démonstration.
Ce sont les performances stables tout au long de longs flux de travail que les entreprises sont réellement prêtes à payer.
Aujourd'hui, les modèles doivent analyser des bases de code, modifier plusieurs fichiers, gérer les erreurs de dépendances, se remettre des défaillances, tout en sachant quand s'arrêter.
La plupart des défaillances du système ne sont pas dues à une seule erreur. Elles résultent d'une dégradation progressive des processus à mesure que ceux-ci s'allongent, jusqu'à ce qu'un intervenant humain doive prendre le relais pour mener la tâche à bien.
La stratégie d'Anthropic : développer l'IA pour les systèmes de production
La stratégie d'Anthropic au cours de l'année écoulée s'est systématiquement articulée autour de cet axe.
Au lieu de se concentrer sur les améliorations les plus visibles à court terme de l'expérience de chat, l'entreprise a orienté le modèle vers une “ unité d'exécution ”.”
Codage, extraction d'informations, analyse de documents, recherche juridique, analyse financière : autant de tâches à faible tolérance d'erreur et à forte valeur ajoutée qui s'inscrivent naturellement dans le cadre des achats d'entreprise.
Les entreprises mises en avant cette fois-ci par Anthropic — Cursor, Notion, Rakuten, CodeRabbit, Warp, Vercel, XBOW — sont toutes liées à des flux de travail spécifiques, et non à des scénarios grand public généraux.
C'est ce qu'il y a de plus intéressant dans la version Opus 4.7.
Anthropic ne s'est jamais lancé à la poursuite des points d'entrée les plus médiatisés.
Elle cible les domaines où se concentrent réellement les budgets des entreprises.
Concours de modèles d'IA : Claude, OpenAI et Google
OpenAI continue de retenir le plus l'attention du public.
Google contrôle toujours la plateforme et la couche d'infrastructure.
L'écosystème open source continue d'exercer une pression sur les marges en faisant baisser les coûts.
Le chemin tracé par Anthropic a toujours été plus étroit… et plus clair.
L'objectif est de mettre en place des processus pour lesquels le retour sur investissement peut déjà être calculé.
Dès lors qu’un modèle est intégré à des processus tels que la génération de code, la gestion de documents, l’analyse financière ou la recherche juridique, le résultat ne se résume pas à un simple “ moment d’émerveillement ” ponctuel. Il devient mesurable : réduction de la charge de travail, délais d’exécution plus courts, taux d’erreur plus faibles.
Et c'est là que les projets pilotes débouchent sur des achats, et que les achats débouchent sur des renouvellements.
Ce que la version 4.7 de Claude Opus signifie pour l'adoption de l'IA en entreprise
Être en tête du classement reste important, mais ce n'est plus déterminant.
L'analyse d'Arena montre qu'Opus 4.7 arrive en tête dans les catégories « Général », « Expert » et « Programmation », et affiche également des progrès en « Écriture créative ».
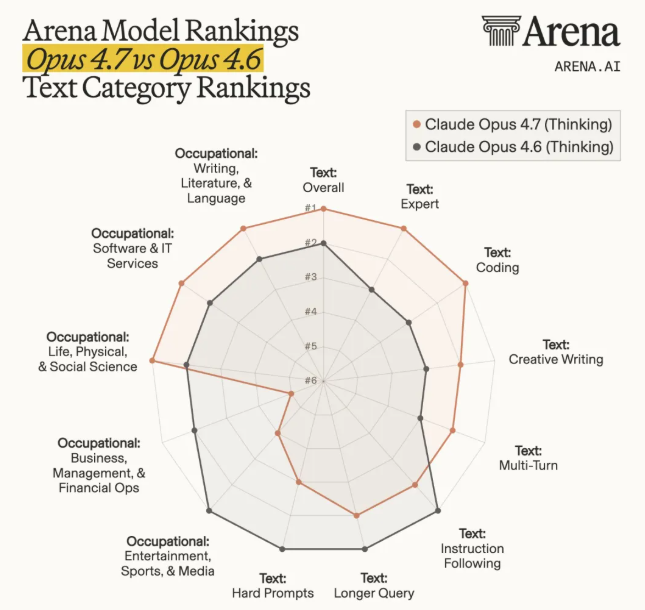
Mais dans certaines catégories, Opus 4.6 reste plus performant.
En réalité, cela en dit long sur la situation actuelle de la concurrence.
La concurrence entre les modèles de pointe ne repose plus sur des sauts générationnels. Elle repose désormais sur les différences de structure des tâches et de combinaison de capacités.
Le marché n'attend pas un modèle unique capable de tout faire. Il recherche le modèle adapté à chaque tâche.
Certains modèles seront plus performants dans les tâches d'ingénierie.
D'autres éléments dans les flux de travail multimodaux.
D'autres le feront être compétitif en termes de prix.
Le classement ne cessera d'évoluer.
Pourquoi Claude Opus 4.7 marque un tournant vers une IA fiable
C'est aussi pour cela que le moment choisi pour la sortie d'Opus 4.7 revêt une importance particulière.
Au moment de sa sortie, les spéculations concernant le prochain modèle d’OpenAI, le GPT-5.5, ont également constitué un sujet récurrent sur le marché. Même les marchés de prédiction tels que Polymarket ont connu une activité accrue.
Pour l'instant, toutefois, tout cela n'est encore que des espoirs.
Ce qui entre réellement dans les processus d'évaluation des entreprises, ce sont des modèles qui ont déjà été lancés, dont les performances ont été évaluées par rapport à des références et qui sont prêts à être intégrés.
Anthropic n'a pas besoin de prouver qu'Opus 4.7 sera le modèle le plus performant dans six mois.
Ce dont elle a besoin — et ce qu’elle est en train de faire —, c’est de se replacer parmi les finalistes aux yeux des acheteurs professionnels et des partenaires de plateforme avant l’arrivée de la prochaine vague majeure de lancements de nouveaux modèles.
Et elle le fait à travers quelque chose de très concret : un modèle qui peut être évalué, intégré et acheté.
À ce stade, cette affaire est déjà claire.
Les résultats des tests de performance, les performances de codage, les améliorations observées dans l'exécution des tâches longues et la réduction des erreurs liées aux outils constituent autant d'éléments qui, pris dans leur ensemble, envoient un message fort :
Anthropic a mis au point un modèle phare mieux adapté aux systèmes de production.
Pour les entreprises, ce signal revêt bien plus d'importance que n'importe quel discours ambitieux sur l'avenir.
Une commande n'est pas attribuée simplement parce qu'une entreprise présente son projet de manière plus convaincante.
Cela s'explique par le fait qu'une autre entreprise est plus à même de fournir des résultats fiables.
Et ce à quoi Anthropic aspire réellement, c'est de disposer d'un pouvoir de fixation des prix lors de la prochaine phase du marché de l'IA d'entreprise.
Foire aux questions
Qu'est-ce que Claude Opus 4.7 ?
Claude Opus 4.7 est le tout dernier modèle d'IA phare d'Anthropic, conçu pour les flux de travail complexes, la programmation et l'exécution de tâches de longue durée. Il apporte des améliorations par rapport à Opus 4.6, avec des scores de benchmark plus élevés et une meilleure fiabilité dans l'utilisation des outils.
Quelle est la qualité de Claude Opus 4.7 par rapport à Opus 4.6 ?
Claude Opus 4.7 surpasse Opus 4.6 dans plusieurs tests de performance, notamment en matière de programmation et de gestion des flux de travail, avec des améliorations au niveau de l'exécution des tâches et du raisonnement en plusieurs étapes, ainsi qu'une réduction significative du nombre d'erreurs liées à l'appel d'outils.
Claude Opus 4.7 est-il plus performant que les modèles GPT ?
Claude Opus 4.7 est très compétitif, notamment en matière de codage et d'exécution de workflows longs. Si les modèles GPT peuvent être en tête en termes d'utilisation générale ou d'écosystème, Opus 4.7 se distingue par sa fiabilité et sa capacité à traiter des tâches structurées.
En quoi Claude Opus 4.7 se distingue-t-il des autres modèles d'IA ?
Claude Opus 4.7 met l'accent sur l'exécution plutôt que sur la simple conversation. Il est conçu pour gérer des tâches longues comportant plusieurs étapes, garantir la stabilité tout au long des flux de travail et réduire les erreurs lors des interactions avec les outils.
Quels sont les principaux cas d'utilisation de Claude Opus 4.7 ?
Claude Opus 4.7 est couramment utilisé pour la codification, l'analyse de documents, la recherche juridique, les processus financiers et d'autres tâches d'entreprise qui exigent précision, cohérence et exécution en plusieurs étapes.
En quoi Claude Opus 4.7 est-il important pour l'IA d'entreprise ?
Claude Opus 4.7 améliore la fiabilité dans les flux de travail réels, ce qui est essentiel pour son adoption en entreprise. Sa capacité à réduire les erreurs et à mener à bien des tâches longues le rend plus adapté aux systèmes de production.
Claude Opus 4.7 prend-il en charge les flux de travail réels ?
Oui. Claude Opus 4.7 est spécialement optimisé pour les flux de travail concrets, notamment l'utilisation d'outils, le raisonnement en plusieurs étapes et l'intégration système, ce qui le rend plus adapté à un déploiement en entreprise.
Vous avez encore des questions sur Claude Opus 4.7 ? Découvrez d’autres informations sur ce modèle d’IA sur DeepInsightAI.