短い答えだ:
~の間 DeepSeek V4 およびOpenAIのGPT-5.5、, GPT-5.5は概して総合的に優れている, 、特に推論、コーディング、および複雑なタスクの実行において。.
しかし、, DeepSeek-V4は競合他社に引けを取らない性能を発揮する—さらに、HTMLの可視化といった一部の分野では他を凌ぐ性能を発揮しつつ、より効率的で軽量でもあります。.
結論として: GPT-5.5は総合的に優れていますが、DeepSeek-V4ははるかに低いコストで優れた性能を発揮します。.
2026年4月24日、ある異例の出来事が起こった。世界中のAI開発者たちにとっては「クレイジー・フライデー」のような一日であり、テクノロジーの歴史に刻まれるかもしれないような日だった。.
未明、OpenAIは発表を打ち切った GPT-5.5 予定通り、その圧倒的なスケールで、再び知能の限界を再定義することを目指している。.
しかし、その衝撃が収まる間もなく、海の向こうでディープシークが動き出し―― DeepSeek-V4 同日、そのまま直接対決へと突入する。.
一方は、壮大なテクノロジーのスペクタクルのように登場した。もう一方は? オープンソース界隈からの、まさに「机をひっくり返す」ような反撃だった。.
~への競争 AGI ふと、背が低くなったように感じた。.
GPT-5.5 対 DeepSeek-V4:直接対決によるベンチマーク比較
パズルテスト:真実、嘘、そしてアイデンティティに関する推論
最初のテストは簡単そうに見えますが、実はそうではありません。.
A、B、C、Dの4人。宝石を盗んだのはそのうちの1人だけだ。.
- A: 盗んでなんかいないよ。.
- B:Cがそれを盗んだ。.
- C:Dがそれを盗んだ。.
- D:Bは嘘をついている。.
既知の条件:
- 真である命題は、正確に2つある
- 泥棒はいつも嘘をつく
- 泥棒でない人は、嘘をつくこともあれば、真実を話すこともある
一見すると、解決できそうに見えるが、実際には、, BもCもすべての条件を満たしている.
これは罠問題です。.
真の試金石は、そのモデルが問題に気づくかどうかである 一意に決定できない.
より優れたモデルであれば、次のように答えるはずです:
犯人は一意に特定できない。BかCのどちらかである可能性がある。条件は不十分である。.
GPT-5.5 すぐにその罠に気づいた。.
DeepSeek-V4, 一方、こちらははるかに時間がかかり、推論の過程がかなり長引いた。しかし、最終的にはやはり正しい結論に達した。.
結果は正しい。ただ、処理に時間がかかるだけだ。.
数学的推論:CoTの深さの限界を検証する
IMOレベルのゲーム問題
推論を極限まで追求するため、彼らは実際の国際数学オリンピックレベルの問題を用いた:
アリスとボブは、パラメータ λ を用いたゲームを行う:
- 奇数ラウンド:アリスが選ぶ xn、かつ総和が ≤ λn である
- 偶数ラウンド:ボブが選ぶ xn、かつ二乗和が n 以下
- プレイヤーが動けない場合、そのプレイヤーは負けとなる
- 無限の対局=勝者なし
課題:どの λ の値において、各プレイヤーに勝利戦略が存在するかを特定すること。.
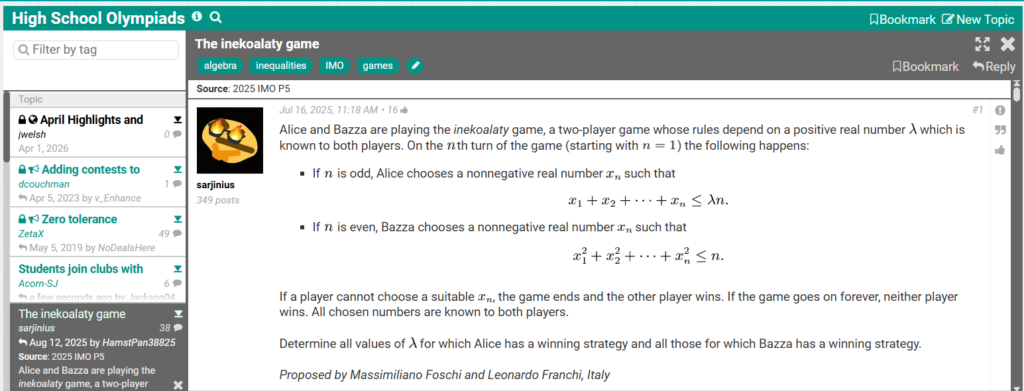
GPT-5.5の性能
「ディープ推論モード」では、, GPT-5.5:
- 正解を導き出した
- Took 2分51秒
- 明確で体系的な推論を示した
- 整然とした書式で納品
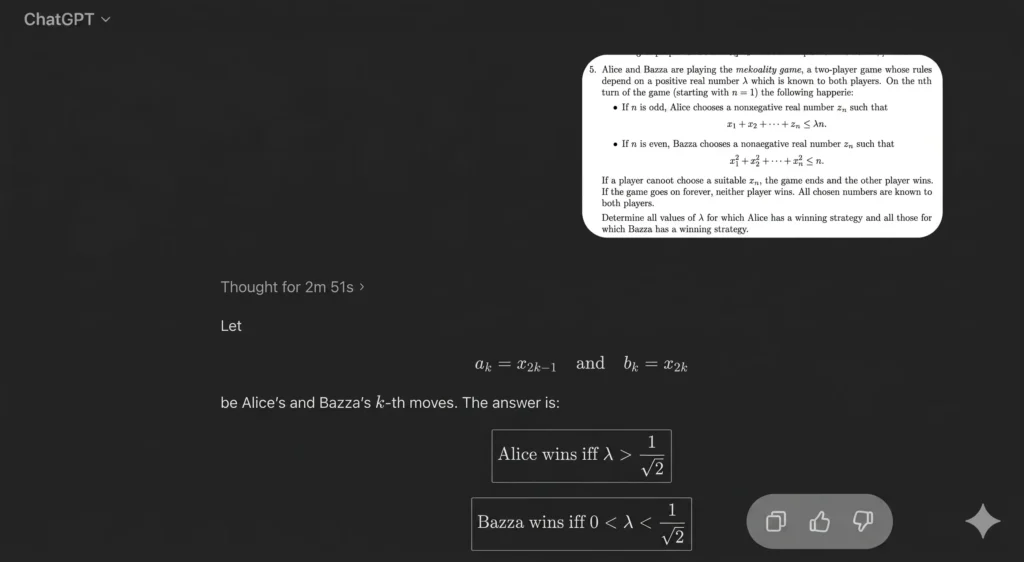
DeepSeek-V4の性能
エキスパートモードが有効な場合:
- 当初は明確な答えが出なかった
- 必須の続き
- ようやく正しい方向が見つかった
- 校正を無事に完了しました
はっきりとわかるように、DeepSeekの推論の深さは大幅に改善されましたが、依然として処理速度は遅く、決断力も不足しています。しかし、その点を考慮すると、 DeepSeekが頻繁に更新されるようになった, 、この差は長くは続かないかもしれない。.
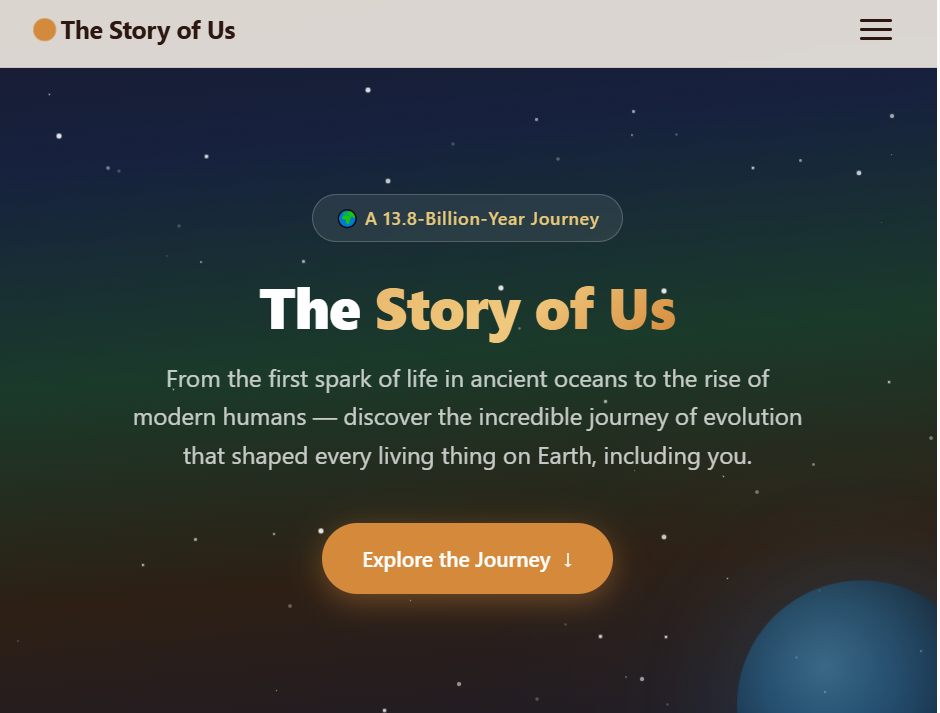
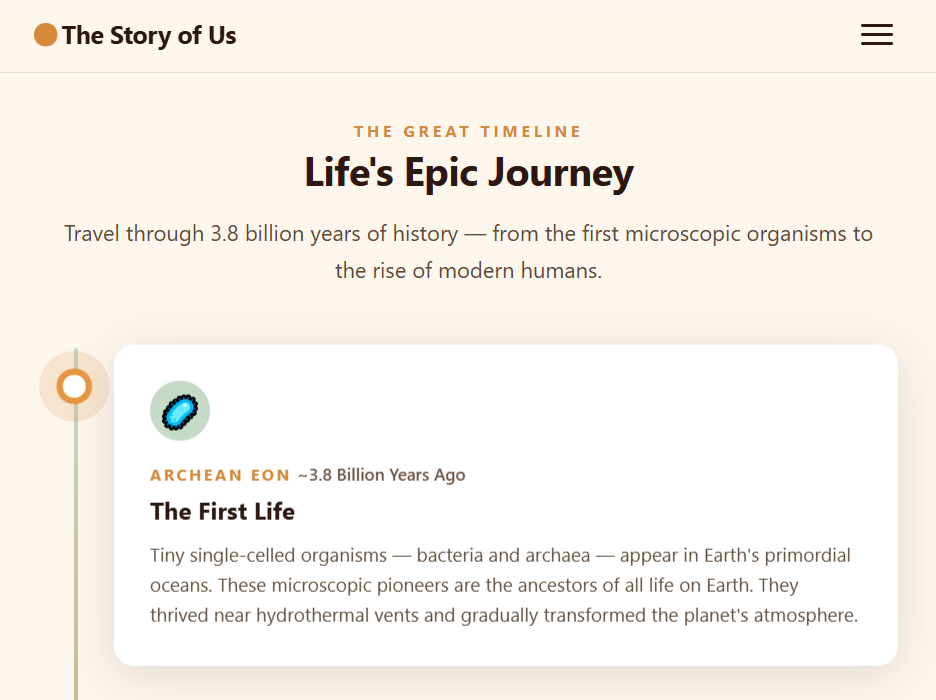
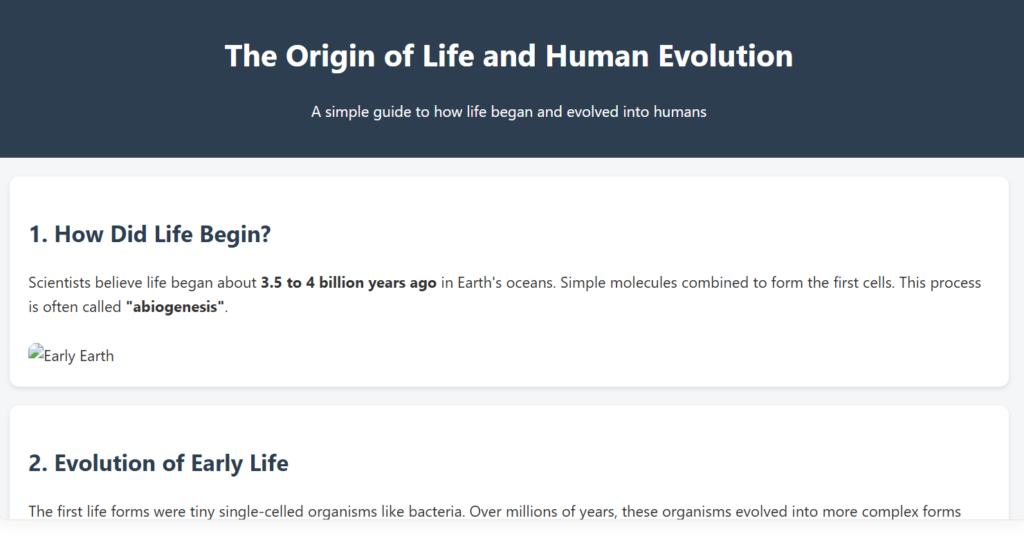
可視化能力:HTMLコンテンツの生成
課題:教育用ウェブページの作成
プロンプト:人間の起源と生物学的進化について、図や画像を用いて解説するHTMLページを作成してください。.
- DeepSeek-V4 ここではより良い結果を出した
- GPT-5.5には書式設定の問題がありました
今回のラウンドはDeepSeekの勝ちだ。.
ゲーム開発:2Dと3Dの機能比較
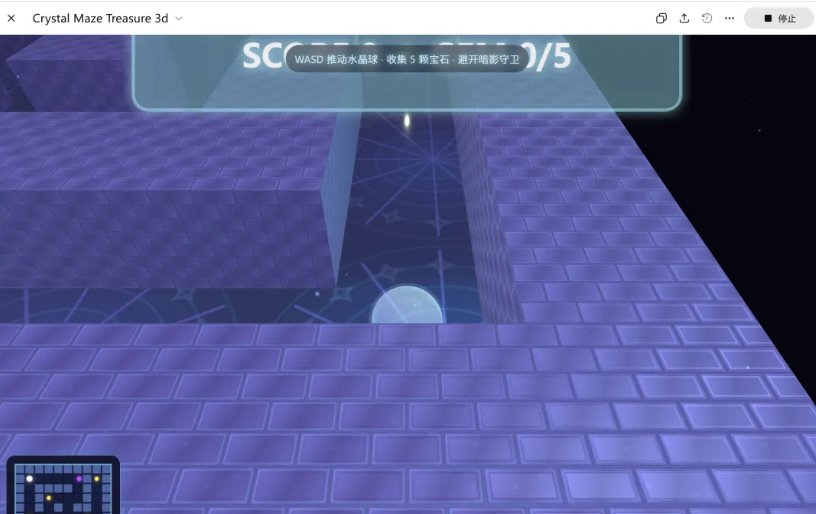
課題:ゲームサイトの構築
要件には以下が含まれていました:
- ダイナミックなグラフィック
- 3Dインタラクション
- 衝突検出
- 全体的なアーキテクチャ
GPT-5.5:
- あっという間に完了した
- 動作確認済みのプレビュー版を納品しました
- レンダリングとアーキテクチャの面でさらに強化
DeepSeek-V4:
- 今回はもっと素早く考える
- しかし、最終生産量は低調だった
今回の対決:GPT-5.5が圧勝した。.
GPT-5.5はより「人間らしい」と感じられる“
初期のテスターや開発者たちの間では、一貫した結論が導き出されました:
GPT-5.5が優れている分野:
- プログラミング
- 推論
- 時間がかかるタスク
しかし、本当に際立っているのは別の点だ――より人間味を感じさせるのだ。.
- 1トークンあたりの価格は高いですが、全体としては安くなります
- よりパワフルでありながら、会話の腕もさらに向上
- より自律的でありながら、より制御しやすくなった
まるでそのモデルが単にアップグレードされただけでなく、性格そのものが変わったかのようです。.
コーデックス・モード:「AI支援プログラミング」を超えて“
GPT-5.5の コーデックスモード 「AIを活用したプログラミング」という概念を事実上排除することになる。“
あるテスターが、この製品に対してPRDを徹底的に実施し、たった一言だけこう述べた: go
数時間後、プロジェクト全体が完了した。.
さらに重要なのは、ワークフローです:
- ビルド
- 目視検査を行う
- 問題の検出
- 反復処理
それは 閉ループ, 、これまでにめったに見られなかった光景だ。.
ノアム・ブラウン氏は、自分の生産性がかつてないほど高まっていると述べ、今ではGPT-5.5を活用してCUDAカーネルを記述し、実験を実行できるようになったと語った。.
長所と短所
強み
- バックエンド開発
- 複雑なデバッグ
- 大規模なコードベースの理解
- スプレッドシート関連のタスク(最先端の性能)
- 長時間実行される研究タスク(最大31時間の自律実行)
AIは「アシスタント」から「請負業者」へと役割を変えつつある。.
弱点
- フロントエンドのデザインは依然としてトップモデルに及ばない
- 時々、過度に慎重になりすぎる
- ユニットテストが過剰にトリガーされる可能性がある
- 時折見られる、乱雑なSVGやレイアウトの近道
しっかりしているが、指導が必要だ。.
GPT-5.5がなぜ違うように感じられるのか
これは、 新しい事前学習フェーズ.
事前学習は、以下の段階に先立ち、モデルの基本的な能力を確立するものです:
- 命令の最適化
- 道具の使用
- 推論の足場
以前のファウンデーションを再利用していたGPT-5.4とは異なり、GPT-5.5では新しいベースが導入されています。.
おそらくそれが、次のような理由を説明しているのだろう:
- 一貫性の向上
- 高効率
- より安定した動作
それが単なる……であるという兆候さえ見られる。 初期チェックポイント より強力な将来のモデルの。.
コストのパラドックス:高価でありながら、実は安上がり
一見すると、, GPT-5.5の価格設定 が5.4より大きい。.
しかし、実際には
- 同じタスクを実行するのに必要なトークンの数が少ない
- タスクをより早く完了できる
- 再試行の回数が少なくて済む
純効果: 実稼働コストの削減
これはAIエージェントにとって非常に重要なことです。なぜなら、トークンの効率性はスケーラビリティに直接影響するからです。.
全体像
GPT-5.5は劇的な「相転移」をもたらさなかった。“
その代わりに、それは:
- 粗い部分を滑らかにした
- 弱点を補強した
- 現実世界の複雑なタスクにおいて、より信頼性が高まった
魔法なんかじゃない。.
明確な目標や背景、検証に取って代わるものではありません。.
しかし、ほとんどの人にとっては、たいていの場合、それの方が単純にうまくいくのです。.
総評:より完成度の高いモデル
GPT-5.5は、単に賢いだけというわけではありません。.
それは、次のようなことなのです:
- より広範な
- より安全
- より一貫性がある
その隙間を埋めてくれます。.
そして、そのことが、ひっそりと、何よりも重要なことなのかもしれない。.