「Claude Opus 4.7」がAIベンチマークで首位に返り咲く
今週は、, アンソロピック 「Claude Opus 4.7」をリリースしました。.
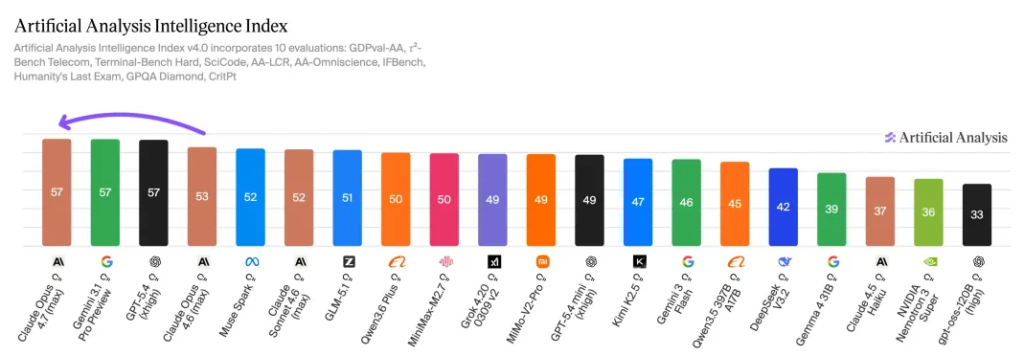
最も注目されている2つの公開ベンチマークにおいて、再びトップの座に返り咲いた。.
「Artificial Analysis」の総合知能ランキングでは、, Opus 4.7のスコアは57で、Opus 4.6の53から上昇した。, 、これにより、間違いなくトップクラスに位置づけられる。.
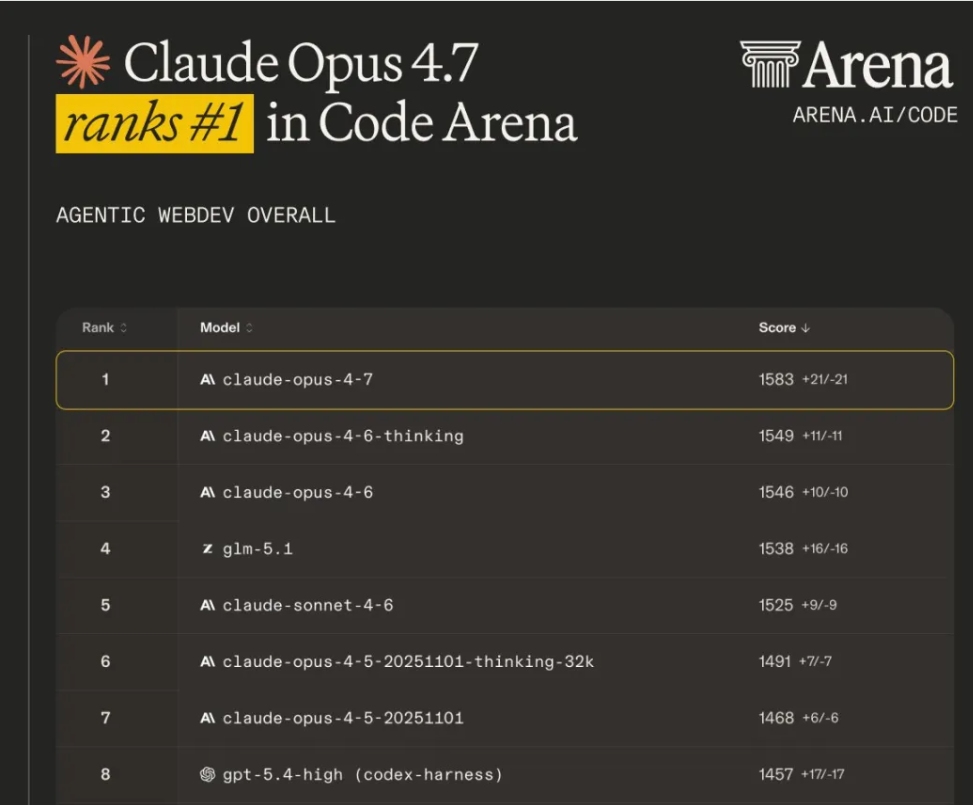
Arena.aiの最新のCode Arenaの結果によると、Opus 4.7が1583点で1位となり、1549点を記録したOpus 4.6 Thinkingを34点上回りました。 また、Anthropic製以外のモデルの中でも最も近いモデルに対して顕著な差をつけ、ReactおよびHTMLの両サブカテゴリーで1位を獲得しました。.
ベンチマーク結果:Claude Opus 4.7 と Opus 4.6 の比較
今回のランキングの意義は、画期的な出来事というよりは、むしろ市場の再調整のようなものだと感じられる。.
この2年間、大規模モデル業界は性能の限界を押し広げることに没頭してきた。パラメータ数がより多いのはどちらか、より長く推論できるのはどちらか、デモの出来がより優れているのはどちらか、そして、あの永遠に遠ざかる理想に、より近づいているのはどちらか――といった具合に。 AGI.
2026年に企業のAIニーズが変化する理由
しかし、2026年までに、企業顧客の求める基準は変化した。.
「どのモデルが最もバランスの取れた天才か」という疑問よりも、はるかに実用的なことについて問われることが多い。
システムに接続できますか?
ワークフローに組み込むことは可能でしょうか?
確実にその仕事をこなせるでしょうか?
Opus 4.7におけるスコアの向上は、まさにこの新しい基準に合致しています。.
Claude Opus 4.7:実稼働ワークフローにおけるパフォーマンスの向上
Anthropicが自ら開示した指標は、非常に一貫した方向性を示している。.
93の社内コーディングベンチマークにおいて、Opus 4.7はOpus 4.6と比較してタスク完了率を13%向上させました。.
CursorBenchでは、パフォーマンスが58%から70%に向上しました。.
Notionの多段階ワークフローテストでは、全体的な有効性が14%向上し、ツール呼び出しのエラーは以前の水準の3分の1にまで減少した。.
Anthropicへの顧客からのフィードバックでも、同様の点が指摘されています:
自律性、エラーの減少、そしてツールが故障しても作業を継続できる能力。.
個々の数字だけを見れば、どれも劇的なものには見えません。しかし、それらを総合的に見ると、明確な実態が浮かび上がってきます。.
チャットから実行まで:ワークフローAIへの移行
Opus 4.7 の改善点は、スケーラビリティが最も確保しにくく、かつビジネス上最も決定的な要素である、長期にわたるタスクの実行、多段階の連携、ツールの信頼性、そして情報が不完全な場合の適切な対応といった機能に集中しています。.
1回のやり取りで回答が得られる仕組みは、もはやデモ用の演出のように感じられ始めています。.
長いワークフローを通じて安定したパフォーマンスを発揮することこそが、企業が実際に費用を支払う価値があると考えている点です。.
今日のモデルは、コードベースを読み込み、複数のファイルを変更し、依存関係のエラーに対処し、障害から回復するとともに、いつ停止すべきかを見極める必要があります。.
システムの不具合の多くは、たった一つの手順を間違えたことが原因ではありません。ワークフローが長くなるにつれて徐々に機能不全に陥り、最終的には人間が介入して作業を完了させなければならない状況に至るのです。.
Anthropicの戦略:本番環境向けAIの構築
過去1年間、Anthropicの戦略は一貫してこの点に重点を置いてきました。.
チャット体験において、目に見える改善効果を即座に得ることを優先するのではなく、このモデルを「実行ユニット」へと進化させる方向で開発を進めてきた。“
コーディング、知識検索、文書レビュー、法務調査、財務分析――これらは、許容誤差が小さく、付加価値の高い業務であり、企業の購買活動と自然に整合するものです。.
今回Anthropicが取り上げている企業――Cursor、Notion、楽天、CodeRabbit、Warp、Vercel、XBOW――は、いずれも幅広い消費者向けシナリオではなく、特定のワークフローに結びついている。.
それがOpus 4.7リリースの最も興味深い点です。.
Anthropicは、これまで決して、最も注目を集めるユーザー獲得の入り口を追い求めてきたわけではない。.
企業の予算が実際に集中している分野に狙いを定めている。.
AIモデルコンテスト:Claude 対 OpenAI 対 Google
OpenAIは依然として最も大きな世間の注目を集めている。.
Googleは依然として、プラットフォームとインフラストラクチャ層を管理している。.
オープンソースのエコシステムは、コスト削減を通じて引き続き利益率を圧迫し続けている。.
Anthropicの歩んできた道は、常に狭く――そして明確でした。.
ROIをすでに算出できるワークフローの実現を目指しています。.
モデルがコード生成、文書処理、財務分析、あるいは法務調査といったプロセスに導入されると、その結果は単なる「感動の瞬間」にとどまりません。それは、労力の削減、処理時間の短縮、エラー率の低下といった、数値で測れる成果となります。.
そして、そこでパイロット事業は調達へと移行し、調達は更新へとつながっていくのです。.
「Claude Opus 4.7」が企業のAI導入に与える意味
ランキングのトップに立つことは依然として重要ですが、もはや決定的な要素ではありません。.
Arenaの分析によると、Opus 4.7は「総合」、「エキスパート」、「コーディング」の各部門で首位に立っており、「クリエイティブライティング」でも成績が向上している。.
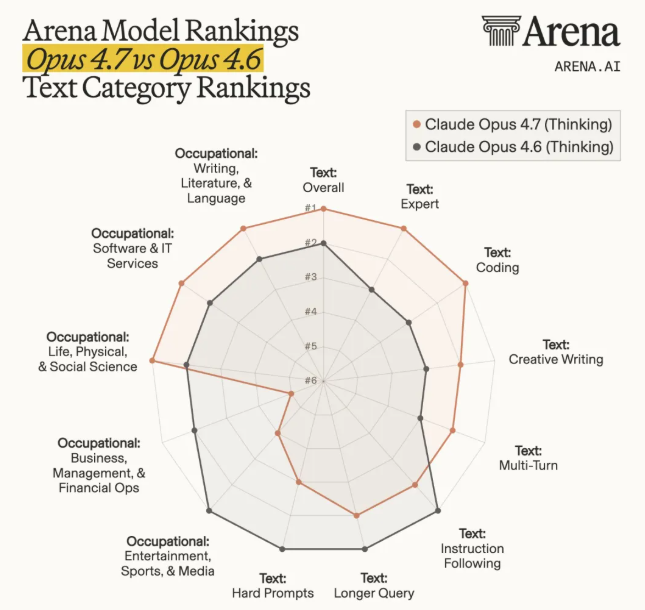
しかし、一部のカテゴリーでは、Opus 4.6の方が依然として優れた性能を発揮している。.
それは、むしろ現在の競争環境がどのような状況にあるかを如実に物語っている。.
最先端モデル間の競争は、もはや世代間の飛躍を争うものではなくなりました。重要なのは、タスクの構造や機能の組み合わせの違いです。.
市場は、あらゆる機能を兼ね備えた単一のモデルを待っているわけではありません。それぞれのタスクに最適なモデルを求めているのです。.
モデルによっては、工学系の課題においてより優れた能力を発揮するものもあります。.
マルチモーダルワークフローにおけるその他の要素。.
他の人たちは…… 価格面で勝る.
順位は今後も変動し続けるでしょう。.
なぜ『クロード・オーパス4.7』が、信頼性の高いAIへの転換を示すのか
だからこそ、Opus 4.7の発表時期も重要なのです。.
このモデルのリリース前後、市場ではOpenAIの次期モデル「GPT-5.5」に関する憶測も繰り返し話題となっています。Polymarketのような予測市場でも、活発な動きが見られています。.
とはいえ、今のところ、そのほとんどはあくまで予想の域を出ない。.
実際に企業の評価パイプラインに取り込まれるのは、すでにリリースされ、ベンチマークテストを経て、統合の準備が整っているモデルである。.
Anthropicは、Opus 4.7が6か月後に最強のモデルになることを証明する必要はない。.
同社に必要なこと――そして現在取り組んでいること――は、次なる大規模なモデルリリースラッシュが到来する前に、企業顧客やプラットフォームパートナーの最終候補リストに再び名を連ねることだ。.
そして、その実現には、評価・導入・購入が可能なモデルという、極めて具体的な手段が用いられています。.
現時点では、その件についてはすでに明らかになっています。.
ベンチマーク結果、コーディングのパフォーマンス、長時間のタスク実行における改善、そしてツールエラーの減少――これらすべてが相まって、明確な兆候を示しています:
Anthropicは、本番環境向けのシステムにより適したフラッグシップモデルを提供した。.
企業顧客にとって、そのシグナルは、未来に関するどんな壮大な物語よりもはるかに重要である。.
ある企業がより説得力のあるストーリーを語ったからといって、調達が決まるわけではない。.
それは、他の会社の方が信頼できる成果を出してくれる可能性が高いからです。.
そして、Anthropicが真に目指しているのは、エンタープライズAI市場の次の段階における価格決定力である。.
よくある質問
「Claude Opus 4.7」とは何ですか?
Claude Opus 4.7は、Anthropic社の最新のフラッグシップAIモデルであり、複雑なワークフロー、コーディング、および長時間かかるタスクの実行向けに設計されています。Opus 4.6からさらに進化し、ベンチマークスコアが向上し、ツールの使用における信頼性も高まっています。.
Claude Opus 4.7は、Opus 4.6と比べてどの程度優れているのでしょうか?
Claude Opus 4.7は、コーディングやワークフロータスクを含む複数のベンチマークにおいてOpus 4.6を上回る性能を示しており、タスクの完了率や多段階の推論能力が向上しているほか、ツール呼び出しエラーも大幅に減少しています。.
Claude Opus 4.7はGPTモデルよりも優れているのでしょうか?
Claude Opus 4.7は、特にコーディングや長時間のワークフロー実行において、非常に高い競争力を発揮します。GPTモデルが一般的な用途やエコシステムにおいて優位にある一方で、Opus 4.7は信頼性や構造化されたタスクにおいてより優れています。.
Claude Opus 4.7は、他のAIモデルと何が違うのでしょうか?
Claude Opus 4.7は、単なる会話ではなく、実行機能に重点を置いています。このバージョンは、長時間にわたる多段階のタスクを処理し、ワークフロー全体を通じて安定性を維持し、ツールとの連携時のエラーを削減するように設計されています。.
Claude Opus 4.7の主な活用事例にはどのようなものがありますか?
Claude Opus 4.7は、コーディング、文書分析、法律調査、金融業務フローなど、正確性、一貫性、および多段階の実行が求められる企業業務で広く利用されています。.
なぜ「Claude Opus 4.7」はエンタープライズAIにとって重要なのでしょうか?
Claude Opus 4.7は、実運用環境における信頼性を向上させており、これは企業での導入において極めて重要です。エラーを低減し、長時間のタスクを完遂できるため、本番システムへの導入に適しています。.
Claude Opus 4.7 は、実際の業務フローに対応していますか?
はい。Claude Opus 4.7は、ツールの使用、多段階の推論、システム統合など、実際のワークフローに合わせて特別に最適化されており、企業での導入においてより実用的なものとなっています。.
「Claude Opus 4.7」についてまだご質問がありますか? AIモデルに関する詳しい情報は、以下をご覧ください。 DeepInsightAI。.