つい先ほど、アルトマン氏が真夜中にGPT-5.5を公開した。対する本格的な攻撃が クロード 作品4.7, 、地球上で最強のモデルの座を奪還した。プログラミングから科学研究に至るまで、AIが自律的にコンピューターを掌握する時代が、まさに到来したようだ。.
今夜、シリコンバレーは眠らない。.
つい先ほど、GPT-5.5が衝撃的なデビューを飾りました。これは、OpenAIがこれまでに開発した中で最も強力かつ高性能な次世代のフラッグシップモデルです。.
これは、まったく新しいレベルの知能を体現しており、エージェント時代の「ネイティブ・ブレイン」へと完全に進化を遂げたものである。.
そうです、待望の「スパッド」がついに今日登場しました。.
GPT-5.5のベンチマーク:全カテゴリーにおける#1のランキング
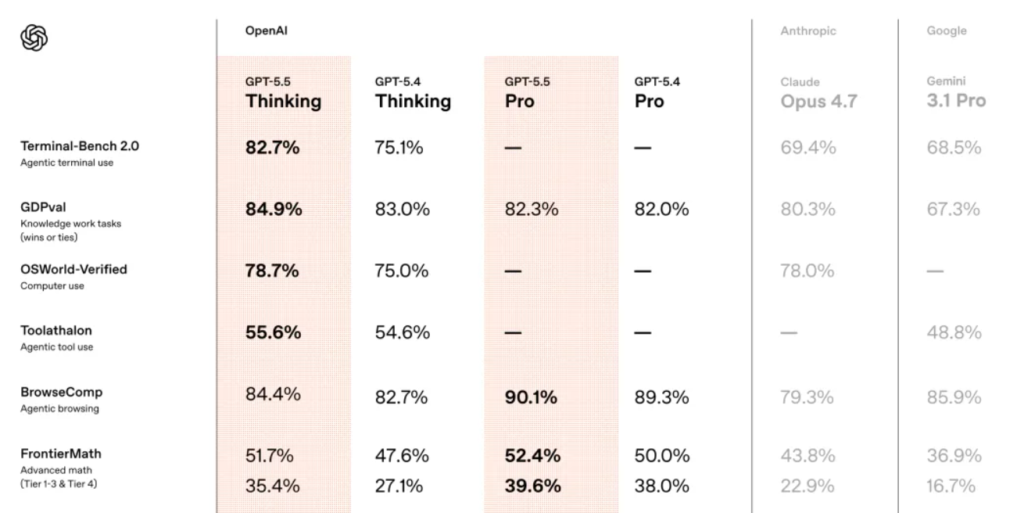
最も目を引く点は、すべての主要なベンチマークテストにおいて、GPT-5.5が1位を獲得しているという点だ。.
プログラミング、推論、数学、エージェントタスクのいずれにおいても、Claude Opus 4.7 や Gemini 3.1 Pro は GPT-5.5 に完全に凌駕されている。.
前世代と比較すると、GPT-5.5 Thinkingはまるで「次元削減攻撃」のような印象を与え、世代間の隔たりを浮き彫りにしている。.
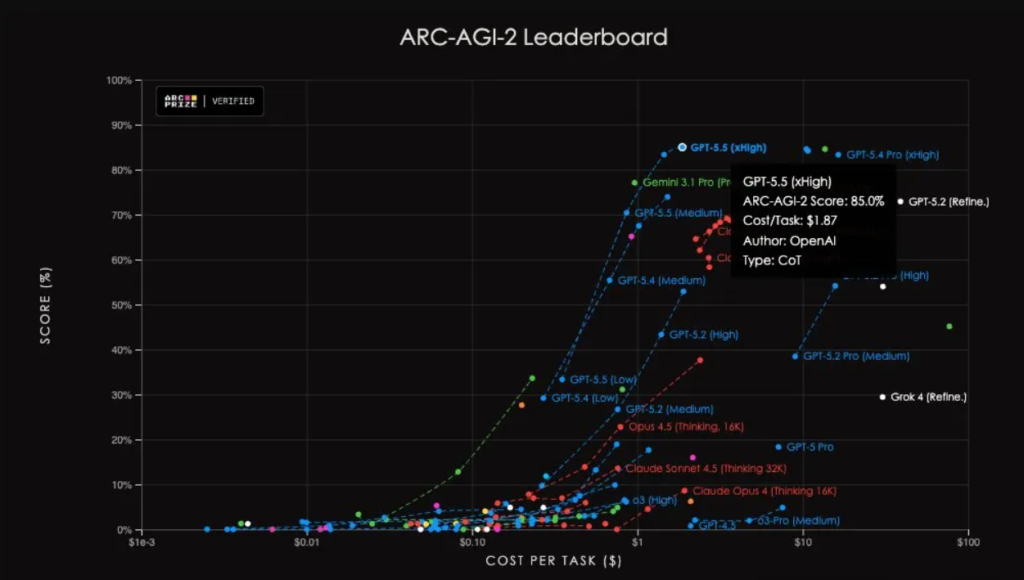
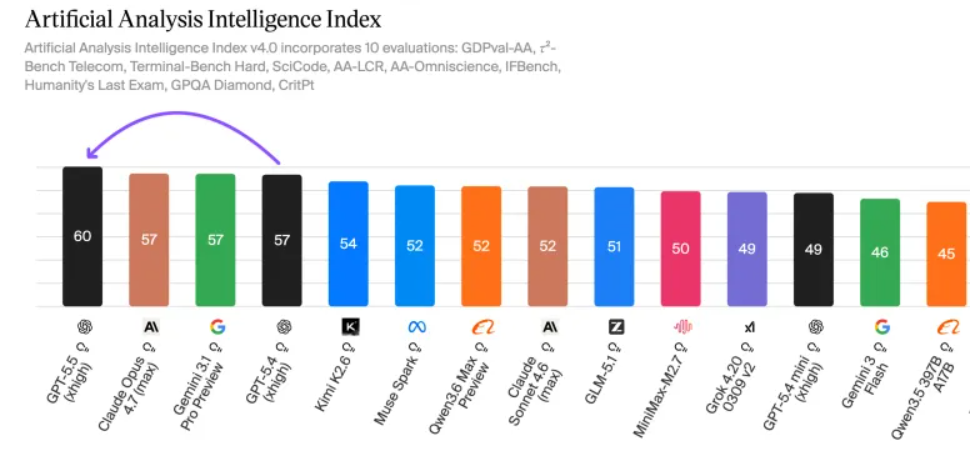
AAIテストにおいて、同じ出力トークンを用いた場合、GPT-5.5は世界最高レベルの知能スコアを記録しました。また、ARC-AGI-2においても、新たなSOTAを樹立しました。.
アルトマン氏は、それを称賛せずにはいられなかった。「GPT-5.5は賢く、しかも高速だ」“
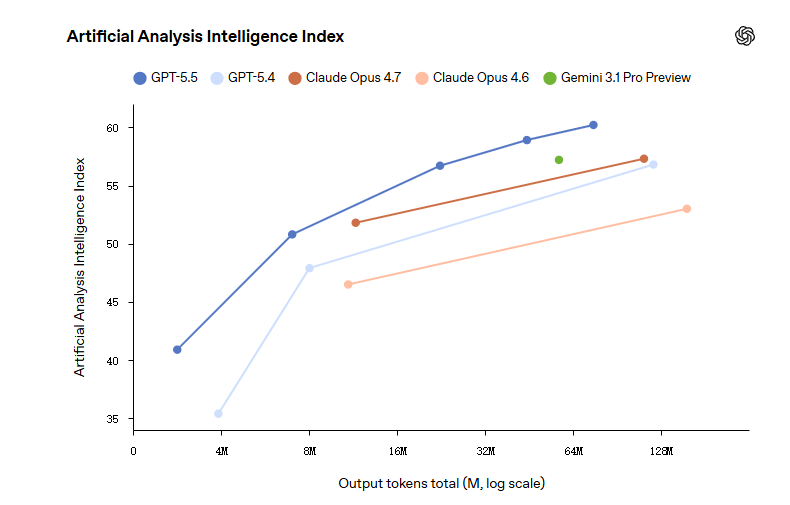
トークンあたりの処理速度はGPT-5.4と同等でありながら、タスクあたりのトークン使用数を大幅に削減しています。.
何をすべきかを、ほぼ直感的に理解することができる。.
社長のグレッグは、興奮した様子でこう語った。「これは、コンピュータとのまったく新しい働き方への第一歩だ。」“
本日より、GPT-5.5が正式にサービスを開始しました。 ChatGPTとCodex.
GPT-5.5のコーディング性能:新たな王者登場
まずは中核となる分野、プログラミングから見ていきましょう。GPT-5.5は見事な巻き返しを見せました。.
OpenAIによると、これは現時点で最も強力なエージェント型コーディングモデルであり、かつての変革と同様にワークフローに革命をもたらすものだという。 バイブ・コーディングからウィッシュ・コーディングへ.
Terminal-Bench 2.0 の結果
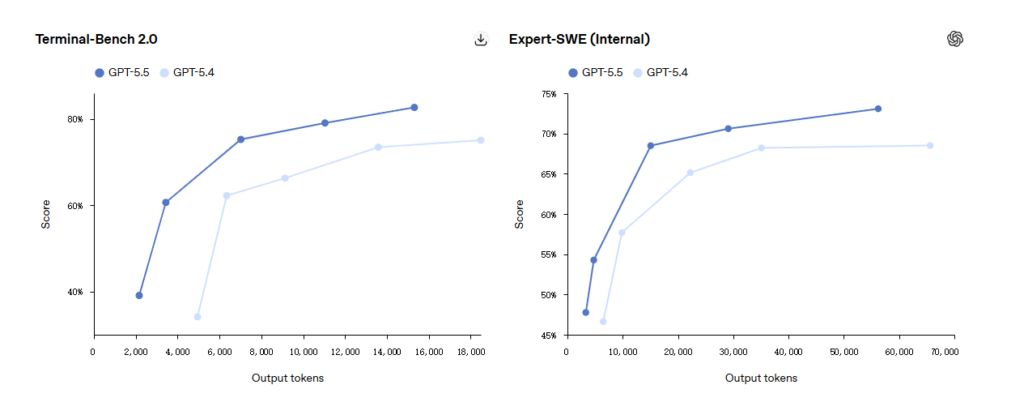
Terminal-Bench 2.0 は、フルチェーンのエージェント設計能力を評価します。.
このモデルには、ターミナル環境と漠然とした目標が与えられます。モデルは、経路の計画、ツールの呼び出し、スクリプトの作成、エラー処理を行い、繰り返し処理を行わなければなりません。.
ここで、GPT-5.5のスコアは82.7%であり、GPT-5.4の75.1%と比較すると、 クロード 作品4.7’の69.4%。13ポイントの差――圧倒的な強さだ。.
Expert-SWEによる評価
OpenAIの内部評価「Expert-SWE」では、人間が20時間かかると推定される長期のプログラミングタスクに焦点を当てた結果、GPT-5.5は73.1%を記録し、GPT-5.4の68.5%を再び上回った。.
SWE-Bench Pro の比較
GitHubにおける実際の問題解決能力を反映していると広く認められているSWE-Bench Proにおいて、GPT-5.5は58.6%を記録し、Claude Opus 4.7(64.3%)にわずかに及ばなかった。.
しかし、OpenAIは次のような注記を付け加えた。「Anthropicは、一部のサブセットにおいて過学習(暗記)の兆候が見られると報告している。」“
つまり、Opus 4.7は以前にもその答えを目にしてきた可能性があるということだが、この懸念は次のような問題と共通する点がある。 GitHub上の「偽のスター経済」.
Codexの研究者たちは、次のように率直に述べている。「SWE-Benchではもはや、トップレベルのコーディング能力を測定することはできない。」.
エンドツーエンドのコーディング機能
重要な点は、これらの評価全体を通じて、GPT-5.5はGPT-5.4を上回る性能を発揮しつつ、使用するトークン数が少ないということです。.
『コーデックス』では、このことがさらに明白になります。.
実装、リファクタリング、デバッグから、テストや検証に至るまで、プログラミング作業の全工程を完結させることができます。.
例えば、アルテミスIIミッション向けの可視化アプリを構築する場合:
GPT-5.5にスクリーンショットを提示し、NASA/JPL Horizonsの実際の軌道データと現実的な軌道力学を用いて、WebGLとViteを使用したインタラクティブな3D軌道シミュレータを実装するよう依頼します。.
GPT-5.5はあらゆるものを一から構築し、次のような高度な空間認識能力を示しています。 Lingbotマップ 3Dマッピング. マウスでドラッグすると、オリオン座、月、太陽の相対的な位置関係がすべて正しく揃います。.
もう一つの例:UFOを撃つ戦車。.
このプロンプトでは、ローポリゴンでありながら視覚的に魅力的なデザインの、Three.js を使ったUFOシューティングゲームの作成が求められています。まず、完全なファイル構造と変更されたファイルの一覧を出力し、その後、すべてのコードを記述する必要があります――「完成するまで止めないでください」。“
GPT-5.5はすべてを処理し、プレイ可能な3Dゲームを一度に完成させます。.
3Dダンジョンアリーナで、, コーデックス ゲームのアーキテクチャ、TypeScript/Three.jsによる実装、戦闘システム、敵との遭遇、およびHUDのフィードバックを担当しています。.
GPTが環境テクスチャを生成し、OpenAI APIが対話を生成し、サードパーティ製のツールがモデル、テクスチャ、アニメーションを提供します。複数のAIが連携して、プレイ可能なゲームを完成させます。.
初期のテスターたちは、GPT-5.5にはシステム構造を理解する能力がより優れていると述べた。.
これにより、問題の発生箇所、修正すべき箇所、およびコードベースのどの部分が影響を受けるかをより正確に特定できます。.
ナレッジワークにおけるGPT-5.5:生産性の真の向上
プログラミングだけでなく、GPT-5.5は知識労働の分野でも高い性能を発揮しています。.
OpenAIはこれを「実務のための新しいタイプの知能」と呼んでいる。“
ユーザーの意図をより素早く把握し、タスクが完了するまでツールを切り替えながら作業を進めます。.
GDPvalのパフォーマンス
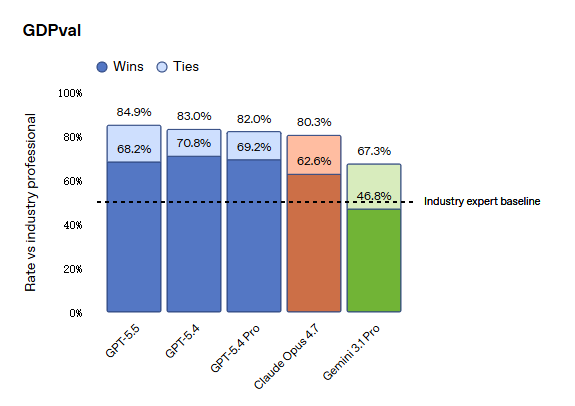
44の職種にわたってAIを評価する「GDPval」において、GPT-5.5は84.9%を記録したのに対し、Opus 4.7は80.3%、Gemini 3.1 Proは67.3%となっている。.
OSWorld認定
モデルが実際のコンピュータ環境を自律的に操作できるかどうかを検証した結果、GPT-5.5は78.7%を記録し、78.0%を記録したOpus 4.7とほぼ同等のスコアとなった。.
Tau2-bench
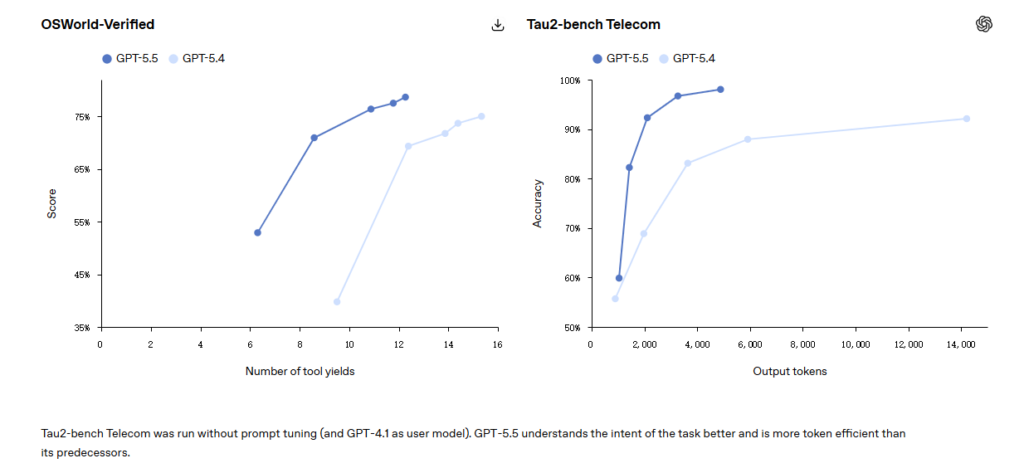
複雑なカスタマーサービスのワークフローにおいて、GPT-5.5はプロンプトによる微調整を行わずに98.0%を達成した。.
OpenAI内での利用
さらに興味深いのは、OpenAI自体がそれをどのように活用しているかという点だ。.
同社のブログによると、各部門を合わせて毎週85%人以上の従業員がCodexを利用している。.
PRチームは、GPT-5.5を活用して過去6か月分の講演依頼を分析し、評価基準とリスク管理の枠組みを構築することで、リスクの低い依頼についてはSlackのAIエージェントが自動的に処理できるようにした。.
財務チームは24,771件のK-1税務申告書(71,637ページ)を審査し、昨年より2週間早く作業を終えた。.
マーケティングチームは週次事業報告書の作成を自動化し、週あたり5~10時間の業務時間を削減しました。.
Codexでは、GPT-5.5がWebアプリと直接やり取りすることができます。ワークフローのテスト、ページのクリック、スクリーンショットの撮影、そして表示内容に基づいた反復処理を行うことが可能です。.
また、より高品質なスプレッドシート、プレゼンテーション、および文書を作成することもできます。.
コンピュータ操作能力が向上したことで、画面上の内容を認識したり、クリックや入力を行ったり、画面内を移動したり、ツール間でコンテキストを簡単に引き継いだりすることが可能になりました。.
OpenAIの研究者ノアム・ブラウン氏は、GPT-5.5を使えば、プロ並みにCUDAカーネルを記述し、実験を実行できると述べた。.
科学研究におけるGPT-5.5:新たな地平を切り拓く
これらに加え、GPT-5.5は、ラムゼー数に関連する新たな証明の発見に貢献し、その証明はLeanによって検証されました。.
ラムゼー数は組合せ論における中核的なテーマであり、本質的には、特定のパターンが必然的に現れるようになるには、ネットワークがどれほどの規模でなければならないかという問いを扱っている。この分野における新たな成果は極めて稀である。.
GPT-5.5は、単にコードを書いたり説明したりしただけでなく、意味のある数学的な論証を提示した。.
科学的ベンチマーク
GeneBenchにおいて、GPT-5.5のスコアは25.0%であり、GPT-5.4の19.0%と比較して高い数値を示している。.
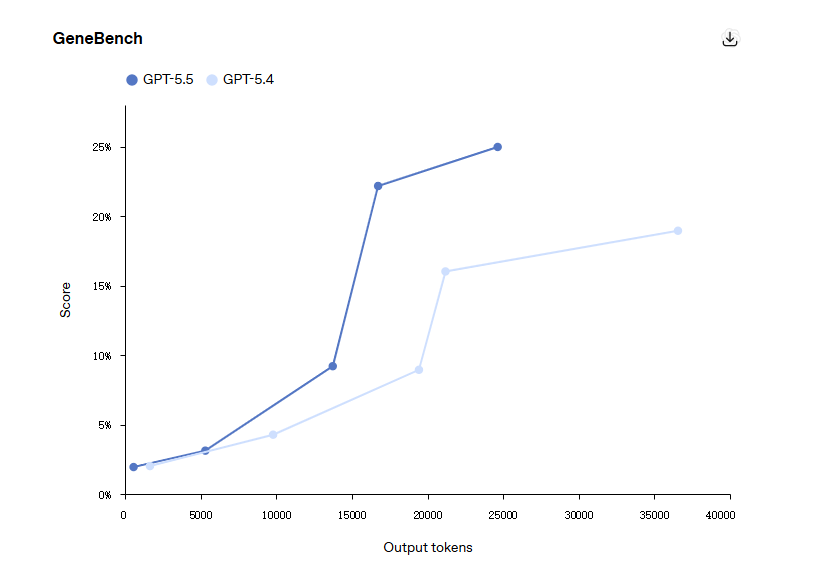
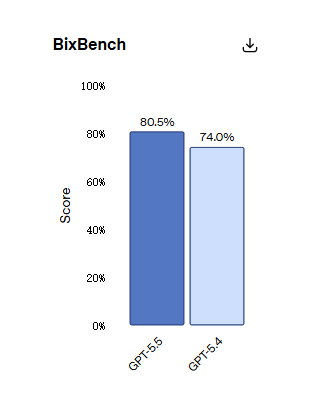
実際のバイオインフォマティクスタスクに基づくBixBenchにおいて、GPT-5.5は80.5%というスコアを記録し、公開されているすべてのモデルの中で1位となった。.
FrontierMath レベル4
FrontierMathのTier 4(テレンス・タオ氏をはじめとする一流の数学者たちが設計した最も難易度の高いレベル)では —において、GPT-5.5は35.4%を記録した。これに対し、GPT-5.4は27.1%、Opus 4.7は22.9%であった。.
その差は12パーセントポイントを上回っている。.
興味深いことに、Tier 1~3の点数差はわずか8ポイントにとどまっており、数学の難易度が高くなるほど、GPT-5.5の優位性が大きくなっていることを示しています。このレベルの推論能力は、アーキテクチャの能力における変化を浮き彫りにしており、同様の傾向は クロード・オーパス4.7 アダプティブ・シンキング.
実際の研究事例
ジャクソン研究所では、免疫学教授のデリヤ・ウヌトマズ氏が、GPT-5.5 Proを用いて、62のサンプルと約28,000個の遺伝子を含むデータセットを分析した。.
このモデルは、主要な調査結果とより深い洞察を明らかにした詳細な調査報告書を作成した。.
これを人間だけで行おうとすれば、数ヶ月はかかるだろう。.
ポズナン大学では、ある数学の助手が「Codex」を用いてわずか11分で代数幾何学のアプリケーションを構築し、二次曲面の交点を可視化するとともに、曲線をワイエルシュトラスモデルに変換した。.
GPT-5.5 対 Opus 4.7:全面的な刷新
プログラミングから知識労働、そして科学研究に至るまで、その結論は明らかだ。.
GPT-5.5は、単なる「マイナーアップデート」ではありません。これは、新しい基盤モデルによって実現された、フルスタックにわたる飛躍的な進化です。.
「Vending-Bench」においても、GPT-5.5はOpus 4.7を大幅に上回る性能を発揮しています。.
Opus 4.7 は 4.6 と同様の振る舞いを見せます。サプライヤーに嘘をついたり、返金の処理を誤ったりすることが多く、これが両者を比較した際のパフォーマンスの違いの背景となっています。 Claude Opus 4.7 対 4.6.
一方、GPT-5.5はフェアに戦っても、やはり勝つ。.
GPT-5.5の価格:2倍高い――しかし、その考え方は間違っている
GPT-5.5 レビュー:API料金の比較(GPT-5.5 対 GPT-5.4 対 Opus 4.7)
| モデル | 入力価格(100万トークンあたり) | 販売価格(100万トークンあたり) | 注記 |
|---|---|---|---|
| GPT-5.5 | $5.00 | $30.00 | Opus 4.7と同じ仕入れ価格、出力コストは約20%高い |
| GPT-5.5 Pro | $30.00 | $180.00 | 価格が大幅に高いプレミアムプラン |
| GPT-5.4 | $2.50 | $15.00 | GPT-5.5のコストの約半分 |
| クロード 作品4.7 | $5.00 | $25.00 | GPT-5.5よりも出力コストが低い |
さて、費用についてですが。.
GPT-5.5 APIの料金体系 入力トークン100万枚あたり$5、出力トークン100万枚あたり$30です。.
GPT-5.4は$2.50と$15で、まさに半分ずつでした。.
GPT-5.5 Proはさらに高性能で、入力は$30、出力は$180となっています。.
に比べると クロード 作品4.7 価格設定, 、投入価格はおおむね同じですが、産出価格は20%高くなっています。.
OpenAIは、これをトークン効率の向上によるものと説明しています。GPT-5.5は、同じタスクを実行する際に、はるかに少ないトークン数で済みます。.
しかし、計算は単純です:
あるチームがGPT-5.4に毎月$100,000を費やしている場合、トークン使用量が30%削減されたとしても、GPT-5.5に切り替えると、請求額は約$140,000に跳ね上がる。.
つまり、GPT-5.5はプレミアム製品であり、より高い知能を得るためには、その分高い料金を支払うことになるのです。.
GPT-5.4は、今後もコストパフォーマンスに優れた選択肢であり続けるでしょう。.
GPT-5.5は、実際にどのような場合に導入する価値があるのでしょうか?
一見すると、GPT-5.5はGPT-5.4よりもかなり高額に見えます。トークン単価はまさに2倍となっています。.
しかし、トークンの価格だけを見て判断するのは誤解を招く。.
本当の疑問は、次の通りです:
GPT-5.5が損益分岐点に達するには、どれだけのトークン削減が必要か?
トークンの効率性によるコスト感応度
| トークンの削減 | GPT-5.4とのコスト効率比較 |
|---|---|
| 0% | +100% |
| 20% | +60% |
| 30% | +40% |
| 50% | ~0%(損益分岐点) |
たとえ……であっても 30%によるトークン使用量の削減, 、それでも総コストは依然として大幅に増加する。.
👉 意味:
GPT-5.5がコスト面で競争力を持つようになるのは、トークンの使用量を ~50%以上, 、あるいは、その出力品質に見合うだけの価値があるかどうか。.
タスクあたりのコスト > トークンあたりのコスト
現代のLLMを評価する上での重要な転換点:
トークンあたりのコストではなく、タスクあたりのコストを最適化すべきです。.
総コストは次のようにモデル化できます:
総コスト = (入力トークン × 入力価格) + (出力トークン × 出力価格)
つまり、より高価なモデルの方が、かえって安くなることもあるということです もしそれが:
- 使用するトークンの数が少ない
- 再試行の回数が少なくて済む
- 1回の処理でより高品質な出力を生成します
👉 実際には、チームは次のような点を評価する傾向が強まっています:
- 成功した完了1件あたりのコスト
- ワークフローあたりのコスト(API呼び出しごとではなく)
GPT-5.5 対 GPT-5.4 対 Opus 4.7:それぞれをいつ使うべきか
🟢 以下の場合は GPT-5.5 を使用してください:
- 業務内容は以下の通りです。 複雑な推論や多段階の計画立案
- 走れ エージェントまたは反復型ワークフロー
- トークンの圧縮には意義がある(長いコンテキスト、構造化されたタスク)
- 出力品質は 事業への直接的な影響
🟡 以下の場合は、GPT-5.5の導入を検討してください:
- タスクの難易度は中程度です
- 一貫性を高めるためなら、多少コストが高くなっても許容できる
- トークン数を減らすために、プロンプトを最適化する予定だ
🔴 以下の場合は、GPT-5.4を使い続けてください:
- タスクは以下の通りです。 単純なもの、あるいは反復的なもの
- 貴社は 大量処理(コンテンツ生成、バッチ処理)
- 費用対効果が最大の制約要因である
GPT-5.5 対 Claude Opus 4.7:実用上のトレードオフ
GPT-5.5とOpus 4.7は入力コストが類似しているものの、出力負荷の高いワークロードにおいては、その経済性が異なってきます。.
経験則:
- 作業負荷が以下の場合は:
- 出力負荷が高い(長い応答、コンテンツ生成)
→ 作品4.7はたいてい安いです
- 出力負荷が高い(長い応答、コンテンツ生成)
- 作業負荷が以下の場合は:
- 推論を多用する(計画立案、コーディング、エージェント)
→ GPT-5.5は全体としてより効率的である可能性がある
- 推論を多用する(計画立案、コーディング、エージェント)
👉 決定は価格だけによるものではありません —
それは ワークフローにおけるトークンの消費方法.
GPTの価格動向:安価なモデルから段階的な知能へ
GPT-5.5は、より広範な変化の兆しを示している:
AIの価格設定は、一律モデルから→段階的な知能モデルへと移行しつつある
- GPT-5.4 → コスト効率に優れたベースライン
- GPT-5.5 → 高性能(デフォルト)
- GPT-5.5 Pro → エンタープライズレベルの知能
これは、次のようなことを示唆しています:
- 比較のため、低価格帯のモデルも引き続きラインナップされます
- 上位モデルは、以下の層をターゲットとする 高付加価値業務
要約 — 意思決定の枠組み
- 最も安い価格をお探しの方 → GPT-5.4を使い続けてください
- もっと説得力のある論証がしたい → GPT-5.5 にアップグレード
- 高価値なワークフローの実行 → 5.5はそれ自体で正当化されるかもしれない
- トークンの削減 <30% → コストは大幅に上昇するでしょう
- トークンの削減 ~50% → 損益分岐点
GPT-5.5は、そのまま置き換えられるようなアップグレードではありません —
それは レバレッジ効果の高いユースケース向けのプレミアムモデル.
大局的な視点:エージェント時代の幕開け
この8日間を振り返ると:
4月16日 — アンソロピック 開始 作品番号 4.7, 、SWE-Bench Proでコーディング部門の王座を獲得した。.
4月24日 — GPT-5.5がリリース。Terminal-Benchでの圧倒的な優位、価格の倍増、画期的な研究。.
2026年のAI競争は、もはや単に「どのモデルがより優れているか」というだけの問題ではなくなっている。“
GPT-5.5に関する説明の中で、OpenAIは「コンピュータとの新しい働き方」――タスクを計画し、複数のツールを使いこなし、ブラウザとローカルソフトウェアの間を自在に行き来する汎用エージェント――を繰り返し強調しています。.
ベンチマークはあくまで前菜に過ぎない。.
エージェントベースの作業こそが、真の戦場である。.
AIがどのように人間の仕事を代替するかを定義する者が、次世代のコンピュータインターフェースを定義することになる。.
8日間で、1サイクルが完結する。.
そして、そのペースはますます加速しており、企業を前進させる驚異的な勢いを反映しているだけでなく、おそらくその理由さえも説明しているのかもしれない。 Anthropicの企業価値が1兆を突破.