DeepSeek V4, 、そのせいで全世界が4月まで辛抱強く待ちわびていたあの作品がついに登場しました!
ついさっき、DeepSeek V4がついに登場しました!
今日、かつてほぼ単独でクローズドソースモデルの独占を打ち破り、そのことを証明したDeepSeekは、 DeepSeekが頻繁に更新されるようになった 業界の勢力図を変えるべく、DeepSeek-V4シリーズのプレビュー版を世界中の開発者に正式に発表しました――
100万レベルのコンテキスト(1M Context)が一般に普及する時代が到来し、オープンソースのエージェントの能力、世界知識、推論性能は新たな高みに達しました。.
DeepSeek V4は、中国およびオープンソース分野において再びトップの座を獲得しました。これは、これまで見られてきた急速な台頭を反映するものであり、 Qwen 3.6 限界を押し広げた。.
V4の技術報告書も同時に公開されました。.
論文の発表場所: https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro/blob/main/DeepSeek_V4.pdf
DeepSeek V4 モデルの概要:V4-Pro 対 V4-Flash
DeepSeek V4-Pro:フラッグシップモデルの仕様
DeepSeek-V4シリーズには2つのバージョンがあります。そのうちの1つが、総パラメータ数1.6T、活性化パラメータ数49Bを誇る、圧倒的な性能を誇るDeepSeek-V4-Proです。.
DeepSeek V4-Flash:効率的でコスト最適化されたバージョン
DeepSeek-V4-Flashは、高効率と経済性を特に重視して設計されており、パラメータ総数は284B、アクティブパラメータ数は13Bです。.
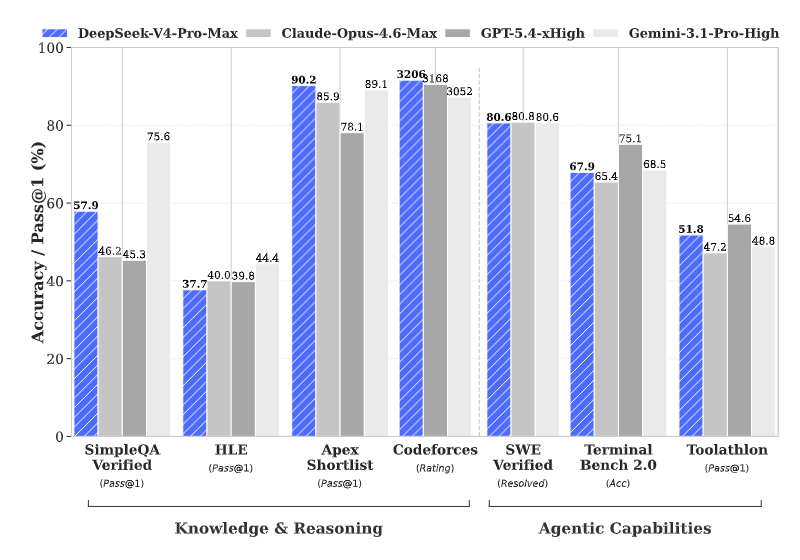
DeepSeek-V4-Proは、オープンソースモデルとして新たな頂点に達し、世界トップクラスのクローズドソースモデルに匹敵する水準に達したと言える。.
DeepSeek V4-Pro の性能:エージェント、知識、推論
DeepSeek V4:エージェント機能における画期的な進歩
まず、V4-Proはエージェント機能において飛躍的な進歩を遂げており、その エージェント型コーディング このレベルは、オープンソースの世界において確固たる第1位の座を占めています。.
実際のテスト結果によると、そのコーディング体験はすでにSonnet 4.5を上回っており、その完成度も 作品4.6 (思考停止モード)。今ではそれが 内部エージェントのプログラミングにおける推奨モデル その会社で。.
DeepSeek V4 のワールドナレッジ・ベンチマークにおける性能
第二に、この分野には豊富な世界に関する知識が蓄積されている。.
知識評価の側面において、V4-Proは類似のオープンソース製品を大幅に上回っており、クローズドソースのベンチマークであるGemini-Pro-3.1との差もごくわずかな範囲にまで縮まっている。.
DeepSeek V4の推論能力とSTEM分野での活用可能性
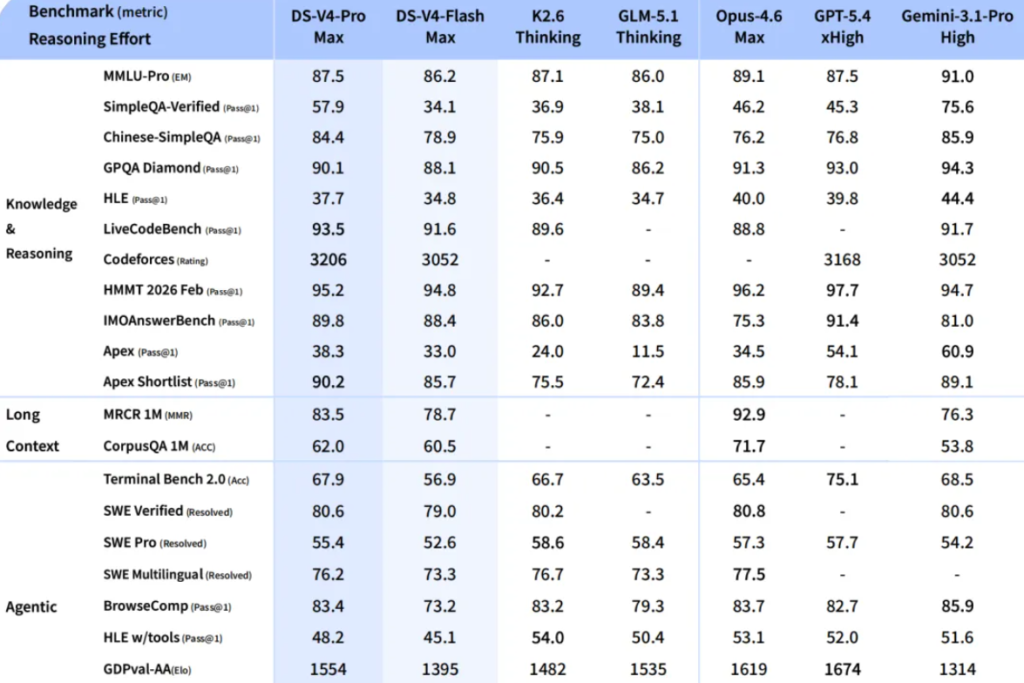
また、論理的推論能力もトップクラスです。.
In 数学やSTEMなどの難解な分野, …そして、難易度の高い競技プログラミングの分野において、V4-Proはオープンソースコミュニティでトップの座を占めるだけでなく、すでに世界最強のクローズドソースモデルに挑むに足る実戦的な競争力も備えています。.
DeepSeek V4のアーキテクチャにおける革新:CSA、HCA、およびmHC
これら2つのモデルが現場を見下ろすことを支えているのが、その基盤となる技術が持つ「3つの優れたスキル」である:
DeepSeek V4におけるハイブリッドアテンション(CSA + HCA)
DeepSeek-V4は、単にハードウェアへの投資を無闇に増やすのではなく、ハイブリッドアテンションアーキテクチャを独創的に設計しました。.
圧縮スパースアテンション(CSA)は、トークン次元に沿ってKVキャッシュを圧縮し、それをDSAスパースアテンションと組み合わせる。一方、重圧縮アテンション(HCA)は、密な計算を維持するために、さらに極端な圧縮を行う。.
この「ロング・ショート・コンビネーション」戦略により、モデルが100万語規模のコンテキストを処理する場合、計算量とメモリ要件を大幅に削減できます。.
DeepSeek V4におけるマニフォールド制約付きハイパーコネクション(mHC)
信号伝播の安定性を向上させ、モデルの表現力を高めるため、V4では従来の残差接続を改良したmHC構造が導入された。.
DeepSeek V4の学習におけるミューオンオプティマイザー
新しいMuonオプティマイザーが導入され、学習プロセスの収束が早くなるだけでなく、安定性も向上しました。.
まさにこうした構造的な革新によって、DeepSeek-V4は推論効率において質的な飛躍を遂げることができたのです。.
100万トークンのコンテキストという極端なシナリオにおいて、DeepSeek-V4-Proの単一トークン推論の計算量は前世代のわずか27%であり、KVキャッシュの使用量は驚くべきことに10%にまで削減されています。.
DeepSeek V4-Flashのパフォーマンス:速度、コスト、および活用事例
Pro版と比較すると、Flash版はより高速で効率的、かつ経済的な選択肢です。.
DeepSeek V4-Flash:推論機能とPro版の比較
世界に関する知識の深さという点ではPro版よりやや劣るものの、DeepSeek-V4-Flashは論理的推論のレベルにおいてPro版に匹敵する水準を維持している。.
DeepSeek V4 API のコスト面および効率面でのメリット
より合理化されたパラメータスケールとアクティベーションメカニズムを活用することで、ユーザーに対し、応答速度が速く、コストも抑えられたAPIアクセスを提供することができます。.
DeepSeek V4 エージェントのタスク実行性能の違い
基本的なエージェントのタスクを処理する場合、V4-FlashのパフォーマンスはPro版とほぼ同等ですが、極めて複雑なタスクに直面した際には、まだ改善の余地があります。.
DeepSeek V4、長文処理で画期的な進歩:100万トークンが標準に
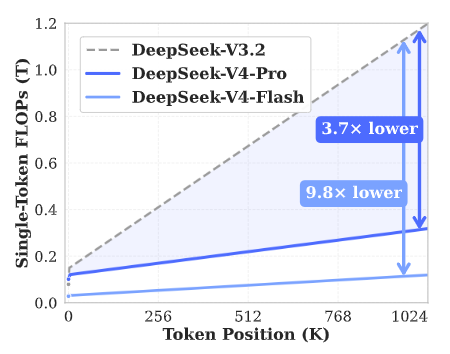
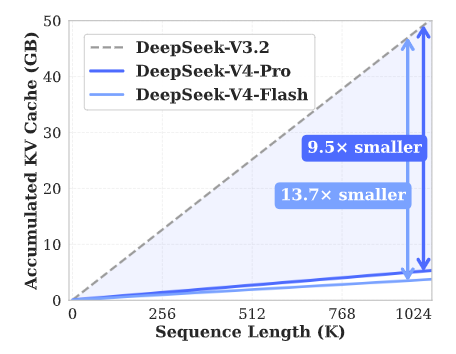
DeepSeek-V4では、画期的なアテンションメカニズムが導入されています。.
トークン次元での効率的な圧縮と、DSAスパースアテンション(DeepSeek Sparse Attention)技術の組み合わせにより、世界トップクラスの長文処理能力を実現しています。.
DeepSeek V4 のデフォルト設定としての 1M コンテキスト
本日より、1M(100万トークン)の超長文コンテキストが、DeepSeek公式サービスの標準設定となります。.
DeepSeek V4 と従来モデルのメモリおよび演算能力の比較
この革新により、コンピューティングリソースやメモリへの依存度が大幅に低減されます。.
コンテキストの長さによるDeepSeek-V4およびDeepSeek-V3.2の計算能力とメモリ容量の変化
DeepSeek V4のエージェント最適化とエコシステムへの統合
DeepSeek V4 とエージェント・フレームワークとの統合
DeepSeek-V4は、Claude Codeなどの主要なエージェント・エコシステムに対してディープアダプテーションを実施しており、, OpenClaw, 、OpenCode、およびCodeBuddy。.
DeepSeek V4 の活用事例:コードおよび文書の生成
コードの記述や文書の自動生成といった場面において、その出力効率は大幅に向上しました。.
特定のエージェント・フレームワークの下で、V4-Proによって自動的に生成されたPPTページの例
DeepSeek V4 API の更新およびモデル移行ガイド
DeepSeek V4 API の使用方法(model_name の設定)
開発者の皆さんにとって朗報なのは、APIも同時に公開されたということです!
これら2つの新しいフラッグシップモデルを利用するには、単に「model_name」を変更するだけで済みます:
- パフォーマンス:deepseek-v4-pro
- 効率:deepseek-v4-flash
DeepSeek V4 モデルの廃止スケジュール
特記事項:従来の「deepseek-chat」および「deepseek-reasoner」というモデル名は、V4の移行期間中の別名として使用されますが、これら2つの旧名称は2026年7月24日をもって正式に廃止されます。.
DeepSeek V4 技術論文の解説
DeepSeek V4のCSA圧縮メカニズムの解説
V4-Proでは、CSAの圧縮比は4です。4つのトークンごとに、KVキャッシュが1つのエントリに統合されます。.
DeepSeek V4 HCA グローバル圧縮戦略
HCAは別のアプローチをとっています。圧縮比は128まで引き上げられており、CSAよりもはるかにアグレッシブな設定となっています。.
DeepSeek V4 ハイブリッドアテンション・コラボレーション設計
これら2つのメカニズムは交互に積み重ねられています。CSAはきめ細かな検索を行い、HCAは全体的な認識を行います。.
DeepSeek V4のトレーニングにおける革新:Muon、MoE、およびディスティレーション
DeepSeek V4 mHCの安定性最適化
mHCは、深層ネットワークにおける発散を防ぐため、残差マッピング行列に制約を課す。.
DeepSeek V4のミューオン・オプティマイザーと学習のコツ
Muonの核心は、勾配運動量の直交化にある。.
DeepSeek V4、MegaMoE、およびシステムの高速化
V4はMegaMoEをオープンソース化し、通信と計算を単一のパイプラインカーネルに統合しました。.
DeepSeek V4 の OPD 蒸留と GRM 報酬モデル
V4では、オンポリシー蒸留を採用し、共同最適化のために生成報酬モデルを導入している。.
オープンソースAIにおいてDeepSeek V4が重要な理由
V3の急激な台頭からV4の効率革命に至るまで、DeepSeekは常に、オープンソースを通じて最先端の技術をコミュニティと共有することを一貫して重視してきました。.
DeepSeek-V4のリリースは、技術的なパラメータの飛躍的な向上であるだけでなく、進化し続けるAIエコシステムに対する力強い対応でもあり、業界内で囁かれているような 「アンソロピック・ミトス」のリーク.
- 100万レベルの長文コンテキスト
- 高性能エージェントシステム
これは、建築的革新を通じて、性能を犠牲にすることなく、大規模モデルの参入障壁を大幅に引き下げることができることを証明しています。.
今すぐ、公式アプリまたは chat.deepseek.com で、新しい「1M」コンテキスト体験をお試しいただけます。.
これは単なるチャットボックスではありません。これは、百科事典全体を収め、数万行ものコードの論理を理解できる「第二の脳」なのです。.
参考文献
https://huggingface.co/collections/deepseek-ai/deepseek-v4
https://modelscope.cn/collections/deepseek-ai/DeepSeek-V4
https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro/blob/main/DeepSeek_V4.pdf