Pochi istanti fa, Altman ha lanciato GPT-5.5 nel cuore della notte. Un attacco su vasta scala contro Claude Opus 4.7, riconquistando il titolo di modello più potente al mondo. Dalla programmazione alla ricerca scientifica, sembra proprio che sia arrivata l’era in cui l’intelligenza artificiale prende autonomamente il controllo del computer.
Stasera la Silicon Valley non dorme.
Proprio ora, GPT-5.5 ha fatto un debutto sensazionale: si tratta del modello di punta di nuova generazione più potente e performante mai realizzato finora da OpenAI.
Rappresenta un livello di intelligenza completamente nuovo, che si evolve pienamente fino a diventare il “cervello nativo” dell’era degli Agenti.
Sì, il tanto atteso “Spud” è finalmente arrivato oggi.
Benchmark di GPT-5.5: classifica di #1 in tutte le categorie
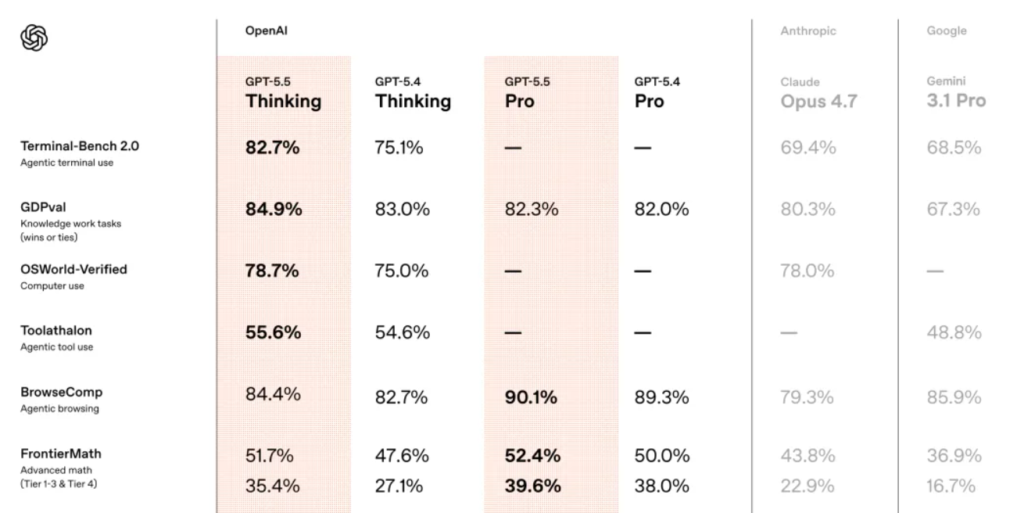
L'aspetto che salta maggiormente all'occhio è questo: in tutti i principali test di benchmark, GPT-5.5 si classifica al primo posto.
Che si tratti di programmazione, ragionamento, matematica o compiti degli agenti, Claude Opus 4.7 e Gemini 3.1 Pro sono nettamente superati da GPT-5.5.
Rispetto alla generazione precedente, GPT-5.5 Thinking sembra quasi un “attacco di riduzione della dimensionalità”, che crea un divario generazionale.
Nel test AAI, con gli stessi token in uscita, GPT-5.5 ottiene il punteggio di intelligenza più alto a livello globale. Anche su ARC-AGI-2 stabilisce un nuovo record SOTA.
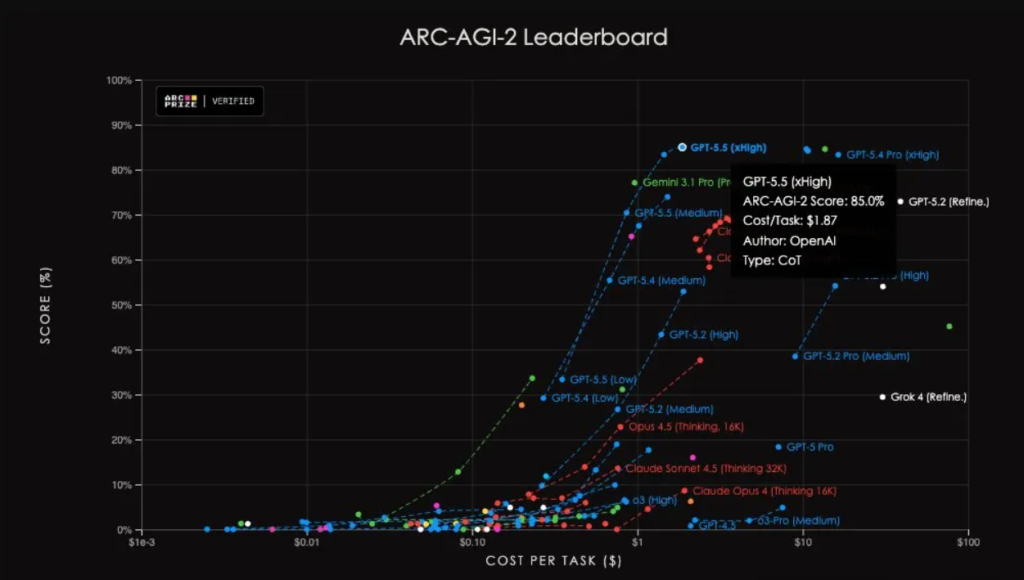
Altman non ha potuto fare a meno di elogiarlo: “GPT-5.5 è intelligente e veloce”.”
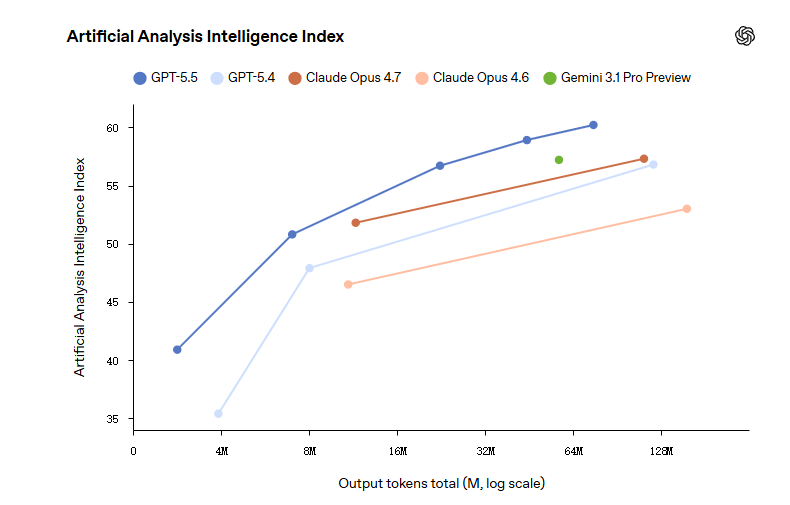
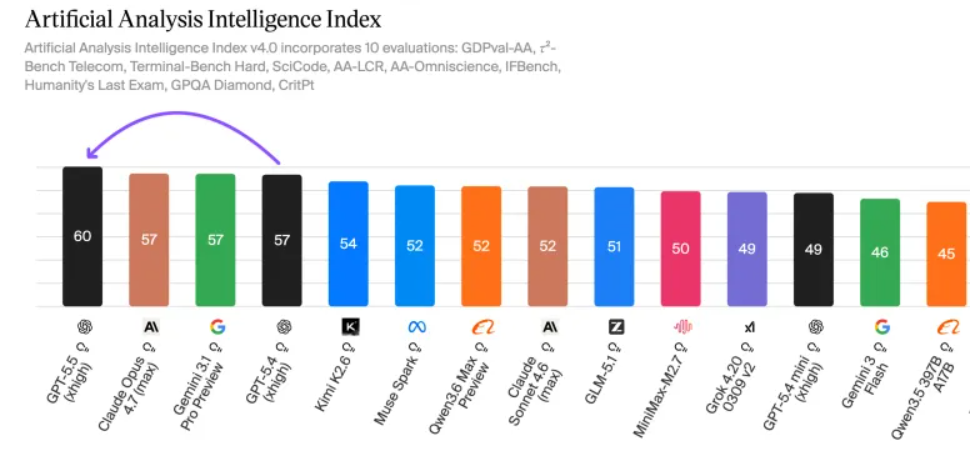
La velocità per token è pari a quella di GPT-5.4, pur riducendo in modo significativo il numero di token utilizzati per ogni operazione.
È in grado di capire quasi intuitivamente cosa bisogna fare.
Greg, il presidente, ha dichiarato con entusiasmo: “Questo è un passo avanti verso un modo completamente nuovo di lavorare con i computer”.”
A partire da oggi, GPT-5.5 è ufficialmente disponibile in ChatGPT e Codex.
Prestazioni di programmazione di GPT-5.5: nasce un nuovo re
Cominciamo dal settore principale: la programmazione. GPT-5.5 torna alla ribalta con grande slancio.
Secondo OpenAI, si tratta del modello di codifica agentica più potente mai realizzato, in grado di rivoluzionare i flussi di lavoro proprio come il cambiamento dalla codifica delle vibrazioni alla codifica dei desideri.
Risultati di Terminal-Bench 2.0
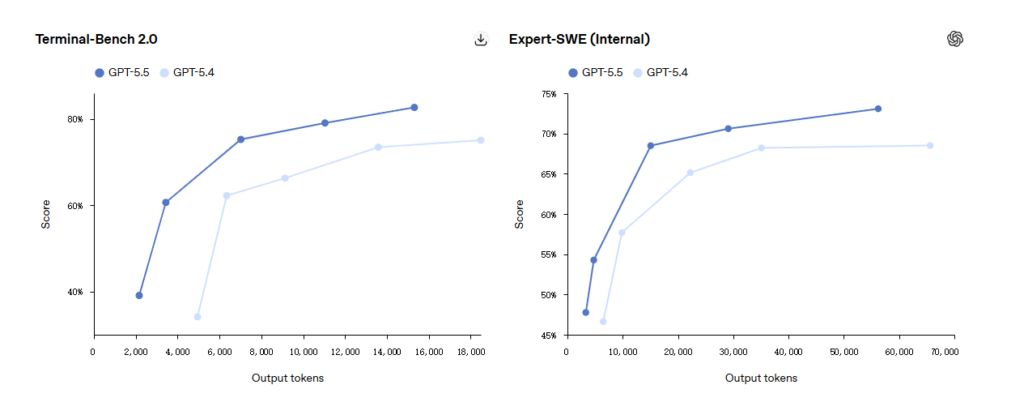
Terminal-Bench 2.0 valuta le capacità di ingegnerizzazione degli agenti lungo l’intera catena.
Al modello vengono forniti un ambiente terminale e un obiettivo generico. Deve pianificare percorsi, richiamare strumenti, scrivere script, gestire gli errori ed eseguire iterazioni ripetute.
In questo caso, GPT-5.5 totalizza 82,71 TP3T, rispetto ai 75,11 TP3T di GPT-5.4 e Claude Opus 4.7’69,41 TP3T. Un distacco di 13 punti: un netto dominio.
Valutazione da parte di esperti - SWE
Nella valutazione interna ’Expert-SWE” di OpenAI, incentrata su attività di programmazione a ciclo lungo che, secondo le stime, richiederebbero 20 ore di lavoro umano, GPT-5.5 ha totalizzato un punteggio di 73,11 TP3T, ancora una volta superiore ai 68,51 TP3T di GPT-5.4.
Confronto tra SWE-Bench Pro
Su SWE-Bench Pro, ampiamente riconosciuto come indicatore della reale capacità di risolvere i problemi su GitHub, GPT-5.5 ottiene un punteggio di 58,61 TP3T, leggermente inferiore a quello di Claude Opus 4.7 (64,31 TP3T).
Tuttavia, OpenAI ha aggiunto una nota: “Anthropic segnala segni di overfitting (memorizzazione) su alcuni sottoinsiemi”.”
In altre parole, Opus 4.7 potrebbe aver già trovato le risposte in precedenza, una preoccupazione che riecheggia questioni come l'economia delle "false stelle" su GitHub.
I ricercatori di Codex hanno addirittura affermato apertamente: SWE-Bench non è più in grado di misurare le competenze di programmazione di alto livello.
Capacità di codifica end-to-end
Il punto fondamentale è che, in tutte queste valutazioni, GPT-5.5 utilizza un numero inferiore di token pur continuando a superare GPT-5.4 in termini di prestazioni.
In Codex, questo risulta ancora più evidente.
È in grado di svolgere attività di programmazione end-to-end: dall'implementazione, al refactoring, al debug, fino al collaudo e alla convalida.
Ad esempio, la realizzazione di un'app di visualizzazione per la missione Artemis II:
Si fornisce a GPT-5.5 uno screenshot e gli si chiede di realizzare un simulatore interattivo di orbite 3D utilizzando WebGL e Vite, con dati reali sulle traiettorie provenienti da NASA/JPL Horizons e meccanica orbitale realistica.
GPT-5.5 costruisce tutto da zero, dimostrando una comprensione spaziale avanzata simile a quella di Mappatura 3D di Lingbot. È possibile trascinare con il mouse e le posizioni relative di Orione, della Luna e del Sole si allineano correttamente.
Un altro esempio: un carro armato che spara agli UFO.
La richiesta prevede la realizzazione di un gioco sparatutto con UFO in Three.js, con un design low-poly ma visivamente accattivante. Il programma deve prima visualizzare la struttura completa dei file e l'elenco dei file modificati, quindi scrivere tutto il codice — “non fermarti finché non hai finito”.”
GPT-5.5 esegue tutto, generando un gioco 3D giocabile in un’unica operazione.
In un'arena con dungeon in 3D, Codice si occupa dell'architettura del gioco, dell'implementazione in TypeScript/Three.js, dei sistemi di combattimento, degli incontri con i nemici e del feedback dell'HUD.
GPT genera le texture dell'ambiente, l'API di OpenAI genera i dialoghi, mentre strumenti di terze parti forniscono modelli, texture e animazioni. Diverse intelligenze artificiali collaborano per realizzare un gioco giocabile.
I primi tester hanno affermato che GPT-5.5 possiede una maggiore capacità di comprendere la struttura del sistema.
Consente di individuare con maggiore precisione dove si trovano i problemi, dove applicare le correzioni e quali parti del codice ne sono interessate.
GPT-5.5 per il lavoro intellettuale: un reale aumento della produttività
Oltre alla programmazione, GPT-5.5 mostra ottime prestazioni nelle attività intellettuali.
OpenAI la definisce “un nuovo tipo di intelligenza per il lavoro concreto”.”
Capisce più rapidamente ciò che vuoi e passa da uno strumento all'altro finché l'attività non è completata.
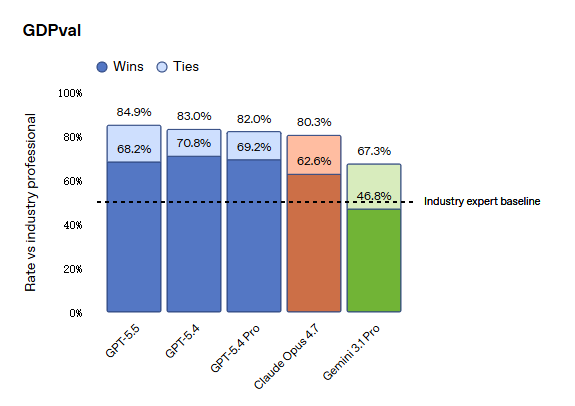
Andamento di GDPval
In GDPval, che valuta l'intelligenza artificiale in 44 professioni, GPT-5.5 ottiene un punteggio di 84,91 TP3T, rispetto agli 80,31 TP3T di Opus 4.7 e ai 67,31 TP3T di Gemini 3.1 Pro.
Verificato da OSWorld
Nel test volto a verificare se i modelli siano in grado di operare in modo autonomo in un ambiente informatico reale, GPT-5.5 ha totalizzato 78,71 TP3T, risultando quasi alla pari con Opus 4.7, che ha totalizzato 78,01 TP3T.
Tau2-bench
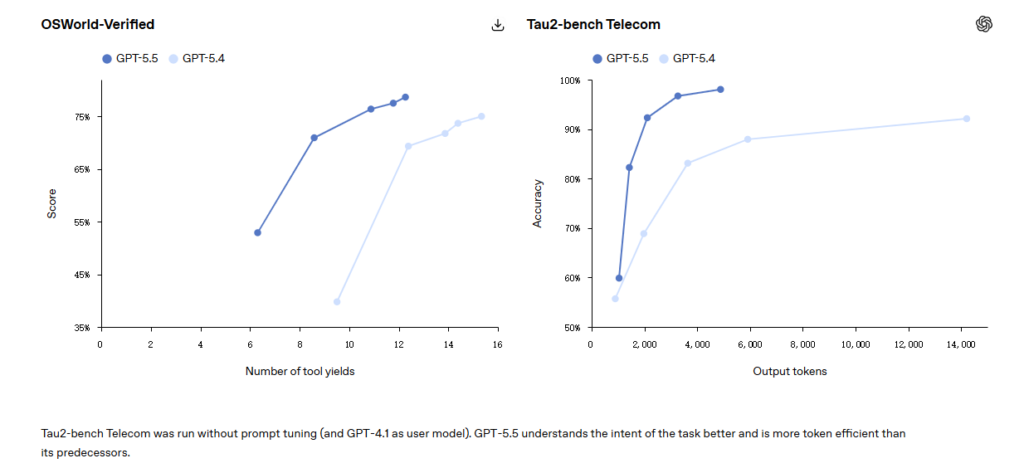
Nei flussi di lavoro complessi del servizio clienti, GPT-5.5 raggiunge un punteggio di 98,01 TP3T senza alcuna messa a punto del prompt.
Uso interno presso OpenAI
Ancora più interessante è il modo in cui la stessa OpenAI lo utilizza.
Secondo quanto riportato sul loro blog, ogni settimana oltre 85% di dipendenti utilizzano Codex in tutti i reparti.
Il team di pubbliche relazioni ha analizzato sei mesi di inviti a interventi pubblici utilizzando GPT-5.5, creando modelli di valutazione e di rischio, in modo che le richieste a basso rischio potessero essere gestite automaticamente dagli agenti IA di Slack.
Il team finanziario ha esaminato 24.771 moduli fiscali K-1 (71.637 pagine), portando a termine il lavoro con due settimane di anticipo rispetto allo scorso anno.
Il team di marketing ha automatizzato i report settimanali sull'andamento dell'attività, risparmiando da 5 a 10 ore alla settimana.
In Codex, GPT-5.5 è in grado di interagire direttamente con le applicazioni web: testare flussi di lavoro, cliccare sulle pagine, acquisire schermate e apportare modifiche in base a ciò che vede.
Inoltre, consente di creare fogli di calcolo, presentazioni e documenti di qualità superiore.
Grazie alle sue capacità avanzate di utilizzo del computer, è in grado di riconoscere i contenuti sullo schermo, cliccare, digitare, navigare e trasferire facilmente il contesto da uno strumento all’altro.
Noam Brown, ricercatore di OpenAI, ha affermato che con GPT-5.5 è in grado di scrivere kernel CUDA e condurre esperimenti come un professionista.
GPT-5.5 nella ricerca scientifica: aprire nuove frontiere
Oltre a tutto ciò, GPT-5.5 ha contribuito alla scoperta di una nuova dimostrazione relativa ai numeri di Ramsey, verificata in Lean.
I numeri di Ramsey rappresentano un argomento fondamentale della combinatoria: in sostanza, si tratta di stabilire quale debba essere la dimensione minima di una rete affinché determinati schemi si verifichino inevitabilmente. I nuovi risultati in questo campo sono estremamente rari.
GPT-5.5 non si è limitato a scrivere codice o a fornire spiegazioni, ma ha proposto un ragionamento matematico significativo.
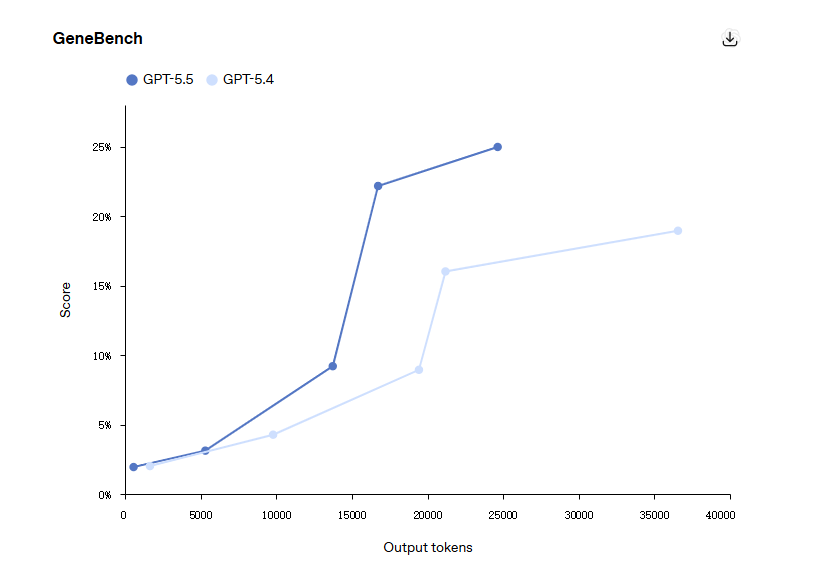
Parametri di riferimento scientifici
Su GeneBench, GPT-5.5 totalizza 25,01 TP3T, rispetto ai 19,01 TP3T di GPT-5.4.
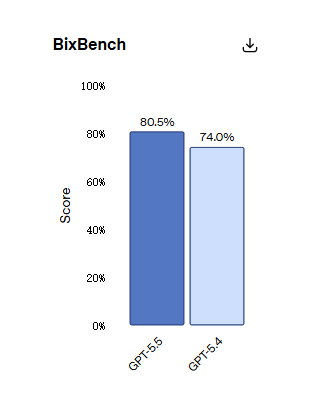
Su BixBench, basato su attività reali di bioinformatica, GPT-5.5 si colloca al primo posto tra tutti i modelli pubblicati con un punteggio di 80,51 TP3T.
FrontierMath Livello 4
In FrontierMath Livello 4 — il livello più difficile ideato da matematici di spicco come Terence Tao — GPT-5.5 ottiene un punteggio di 35,41 TP3T, rispetto ai 27,11 TP3T di GPT-5.4 e ai 22,91 TP3T di Opus 4.7.
Il divario supera i 12 punti percentuali.
È interessante notare che il divario tra i livelli 1 e 3 è di soli 8 punti, il che significa che più la matematica è avanzata, maggiore è il vantaggio di GPT-5.5. Questo livello di ragionamento evidenzia un cambiamento nelle capacità architetturali, un orientamento che si riscontra in modo simile in Claude Opus 4.7: pensiero adattivo.
Esempio concreto di ricerca
Presso il Jackson Laboratory, la professoressa di immunologia Derya Unutmaz ha utilizzato GPT-5.5 Pro per analizzare un set di dati composto da 62 campioni e quasi 28.000 geni.
Il modello ha prodotto un rapporto di ricerca dettagliato, individuando i risultati principali e fornendo approfondimenti più approfonditi.
Un team composto da persone impiegherebbe mesi per farlo.
All’Università di Poznań, un assistente di matematica ha realizzato in soli 11 minuti un’applicazione di geometria algebrica utilizzando Codex, che permette di visualizzare le intersezioni di superfici quadriche e di convertire le curve in modelli di Weierstrass.
GPT-5.5 contro Opus 4.7: una revisione completa
Dalla programmazione al lavoro intellettuale fino alla ricerca scientifica, la conclusione è chiara.
GPT-5.5 non è solo l’ennesima “iterazione minore”. Si tratta di un salto di qualità a tutto campo reso possibile da un nuovo modello di base.
Anche in Vending-Bench, GPT-5.5 supera nettamente Opus 4.7.
Opus 4.7 si comporta in modo simile alla versione 4.6: spesso mente ai fornitori e gestisce in modo scorretto i rimborsi, il che spiega le differenze di prestazioni che si riscontrano nel confronto Claude Opus 4.7 vs 4.6.
GPT-5.5, invece, gioca lealmente e vince comunque.
Prezzi di GPT-5.5: due volte più costoso — ma non è questo il modo giusto di vedere la questione
Recensione di GPT-5.5: confronto dei prezzi delle API (GPT-5.5 vs GPT-5.4 vs Opus 4.7)
| Modello | Prezzo di acquisto (per 1 milione di token) | Prezzo di vendita (per 1 milione di token) | Note |
|---|---|---|---|
| GPT-5.5 | $5.00 | $30.00 | Prezzo di acquisto uguale a quello dell’Opus 4.7, costo di produzione superiore di circa 201 TP3T |
| GPT-5.5 Pro | $30.00 | $180.00 | Livello Premium con prezzi notevolmente più elevati |
| GPT-5.4 | $2.50 | $15.00 | Circa la metà del costo di GPT-5.5 |
| Claude Opus 4.7 | $5.00 | $25.00 | Costi di produzione inferiori rispetto a GPT-5.5 |
E ora, il costo.
Prezzi dell'API GPT-5.5 è pari a $5 per milione di token in ingresso e a $30 per milione di token in uscita.
GPT-5.4 era $2.50 e $15 — esattamente la metà.
GPT-5.5 Pro è ancora più potente: $30 in ingresso, $180 in uscita.
Rispetto a Prezzi di Claude Opus 4.7, il prezzo dei fattori di produzione è simile, ma il prodotto finale costa 20% in più.
OpenAI attribuisce questo risultato a una maggiore efficienza dei token. GPT-5.5 utilizza un numero significativamente inferiore di token per le stesse attività.
Ma il calcolo è semplice:
Se un team spende $100.000 al mese per GPT-5.4, anche con una riduzione del 30% nell'utilizzo dei token, il passaggio a GPT-5.5 farebbe salire il costo a circa $140.000.
In altre parole, GPT-5.5 è un prodotto di fascia alta: si paga di più per un’intelligenza più avanzata.
GPT-5.4 rimarrà probabilmente l'opzione più conveniente.
Quando vale davvero la pena utilizzare GPT-5.5?
A prima vista, GPT-5.5 sembra notevolmente più costoso di GPT-5.4: il prezzo per token è esattamente il doppio.
Tuttavia, considerare solo il prezzo dei token è fuorviante.
La vera domanda è:
Di quale riduzione dei token ha bisogno GPT-5.5 per raggiungere il punto di pareggio?
Sensibilità ai costi in base all'efficienza dei token
| Riduzione dei token | Costo effettivo rispetto a GPT-5.4 |
|---|---|
| 0% | +100% |
| 20% | +60% |
| 30% | +40% |
| 50% | ~0% (punto di pareggio) |
Anche con un 30%: riduzione dell'uso dei token, il costo totale aumenta comunque in modo significativo.
👉 Implicazione:
GPT-5.5 diventa competitivo in termini di costi solo se riduce l'utilizzo di token del ~50% o più, oppure se la qualità del risultato giustifica il costo maggiore.
Costo per attività > Costo per token
Un cambiamento fondamentale nella valutazione dei modelli di linguaggio di grandi dimensioni (LLM) moderni:
Dovresti ottimizzare in base al costo per attività, non al costo per token.
Il costo totale può essere rappresentato come segue:
Costo totale = (Token in entrata × Prezzo in entrata) + (Token in uscita × Prezzo in uscita)
Ciò significa che un modello più costoso può comunque risultare più conveniente se:
- Utilizza un numero inferiore di token
- Richiede un numero inferiore di tentativi
- Garantisce risultati di qualità superiore in un unico passaggio
👉 In pratica, i team stanno valutando sempre più spesso:
- Costo per completamento andato a buon fine
- Costo per flusso di lavoro (non per chiamata API)
GPT-5.5 vs GPT-5.4 vs Opus 4.7: quando utilizzare ciascuno di essi
🟢 Utilizza GPT-5.5 se:
- Le mansioni comprendono ragionamenti complessi o pianificazione in più fasi
- Corri agenti o flussi di lavoro iterativi
- La compressione dei token è utile (contesti lunghi, attività strutturate)
- La qualità di stampa ha impatto diretto sulle attività aziendali
🟡 Prendi in considerazione GPT-5.5 se:
- I compiti sono di media complessità
- Si può accettare un costo più elevato in cambio di una maggiore uniformità
- Hai intenzione di ottimizzare i prompt per ridurre il numero di token
🔴 Continua a usare GPT-5.4 se:
- I compiti sono semplice o ripetitivo
- Operate a elevati volumi (creazione di contenuti, elaborazione in batch)
- L'efficienza in termini di costi è il vincolo principale
GPT-5.5 contro Claude Opus 4.7: compromesso pratico
Sebbene GPT-5.5 e Opus 4.7 abbiano prezzi di input simili, la loro redditività diverge nei carichi di lavoro con un elevato volume di output.
Regola generale:
- Se il tuo carico di lavoro è:
- Elevato carico di output (risposte lunghe, generazione di contenuti)
→ L'Opus 4.7 è spesso più economico
- Elevato carico di output (risposte lunghe, generazione di contenuti)
- Se il tuo carico di lavoro è:
- Con forte enfasi sul ragionamento (pianificazione, programmazione, agenti)
→ GPT-5.5 potrebbe risultare complessivamente più efficiente
- Con forte enfasi sul ragionamento (pianificazione, programmazione, agenti)
👉 La decisione non dipende solo dal prezzo —
si tratta di come vengono utilizzati i token nel tuo flusso di lavoro.
Andamento dei prezzi del GPT: dai modelli economici all’intelligenza a più livelli
GPT-5.5 segna una svolta più ampia:
I modelli di determinazione dei prezzi dell'IA stanno passando da modelli uniformi → a livelli di intelligenza differenziati
- GPT-5.4 → Modello di riferimento economico
- GPT-5.5 → Impostazione predefinita ad alte prestazioni
- GPT-5.5 Pro → Intelligenza di livello aziendale
Ciò suggerisce che:
- I modelli di livello inferiore rimarranno per motivi di scala
- I modelli di fascia più alta saranno destinati a attività di alto valore
In breve — Modello decisionale
- Vuoi il prezzo più basso → Rimani su GPT-5.4
- Vuoi un ragionamento migliore? → Passa a GPT-5.5
- Esecuzione di flussi di lavoro ad alto valore → Il punto 5.5 potrebbe rivelarsi giustificato
- Riduzione dei token <30% → I costi aumenteranno in modo significativo
- Riduzione dei token ~50% → Punto di pareggio
GPT-5.5 non è un aggiornamento "drop-in" —
è un modello premium per casi d'uso ad alto impatto.
Il quadro generale: è iniziata l’era degli agenti
Uno sguardo agli ultimi 8 giorni:
16 aprile — Antropico lanci Opus 4.7, aggiudicandosi il titolo di miglior programmatore su SWE-Bench Pro.
24 aprile — Lancio di GPT-5.5. Dominio su Terminal-Bench, prezzi raddoppiati, ricerca all’avanguardia.
La corsa all'intelligenza artificiale del 2026 non verte più solo sulla questione di “quale modello sia più potente”.”
Nella descrizione di GPT-5.5, OpenAI continua a sottolineare un ’nuovo modo di lavorare con i computer“: un agente generale in grado di pianificare attività, utilizzare più strumenti e passare dal browser al software locale.
I benchmark sono solo un assaggio.
Il lavoro basato sugli agenti è il vero campo di battaglia.
Chiunque definisca in che modo l’intelligenza artificiale sostituisca il lavoro umano, definisce l’interfaccia informatica di prossima generazione.
Otto giorni, un ciclo completo.
E il ritmo non fa che accelerare, a testimonianza dell'incredibile slancio che spinge le aziende in avanti, spiegando forse anche il motivo per cui La valutazione di Anthropic supera i 1.000 miliardi.