簡単な答え:
Opus 4.6は現在、実際のコーディングワークフローにおいて、より高い信頼性、低コスト、そしてより高い初回成功率を実現しており、一方で 作品番号 4.7 自由形式の課題では可能性を示しているが、同様の結果を得るためには、さらなる微調整、より多くのトークン予算、およびより多くの再試行が必要である。.
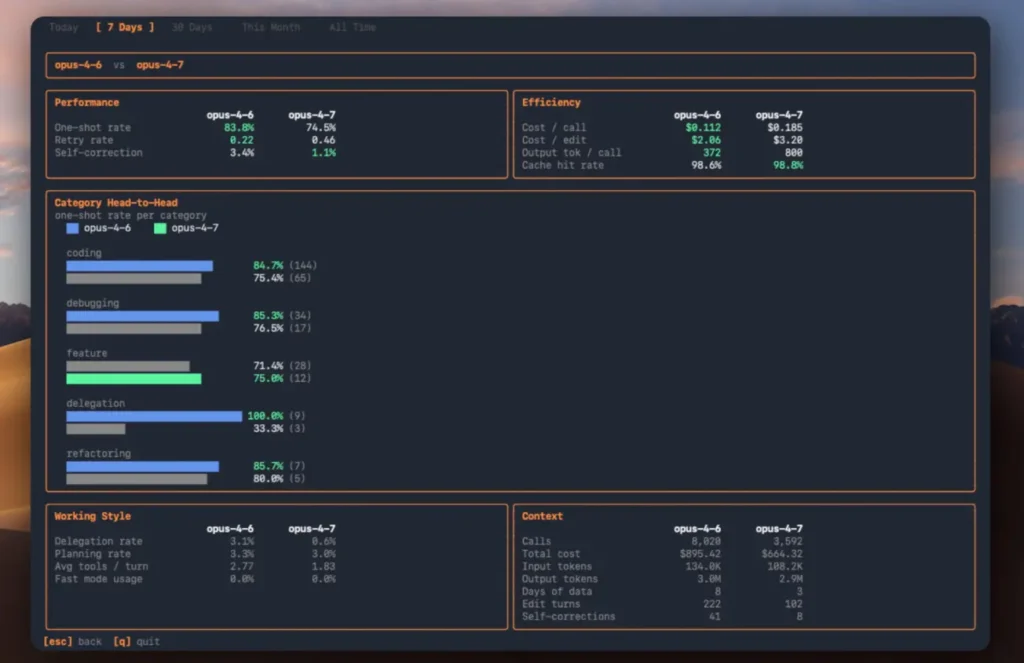
Opus 4.7 対 Opus 4.6:実使用時のパフォーマンスとベンチマークの比較
以下の間の比較のほとんどは Opus 4.7 および Opus 4.6 管理されたベンチマークに依存している。しかし、実際の開発ワークフローの中で数日間にわたって評価してみると、異なる実態が浮かび上がってくる。.
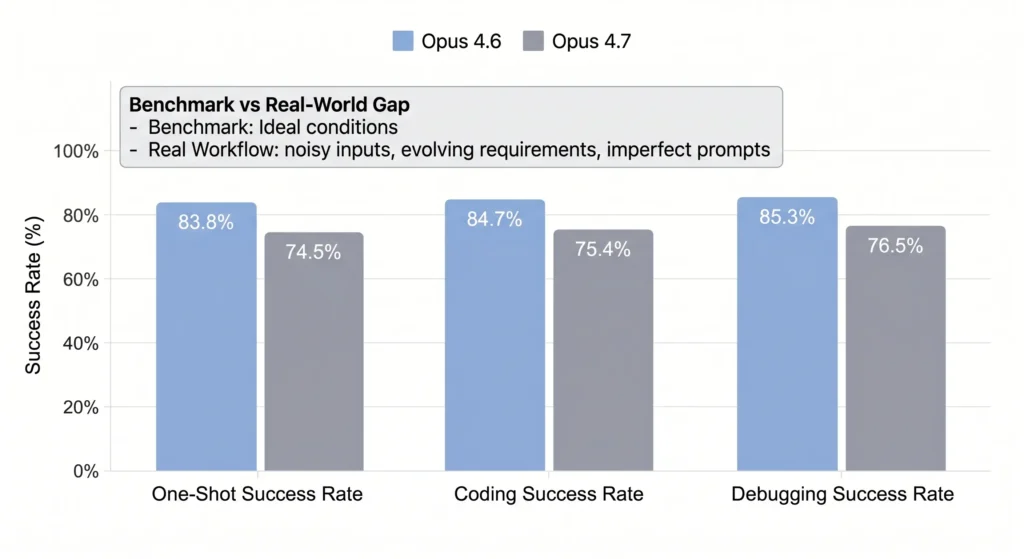
数千件に及ぶ実際のコーディングのやり取りを用いた、数日間にわたる並行評価において:
- Opus 4.6を達成しました 83.8%の初回成功率
- 『Opus 4.7』は 74.5%
- デバッグの成功率は、 85.3% → 76.5%
- コーディング課題の成功率は、 84.7% → 75.4%
この隔たりは、ある重要な違いを浮き彫りにしています:
ベンチマークでの成果が、必ずしも生産効率の向上につながるわけではありません。.
実際のワークフローでは、不完全な文脈、変化し続ける要件、不完全なプロンプトといった「ノイズ」が生じがちです。こうした状況下でも、Opus 4.6 はより柔軟かつ信頼性の高い性能を発揮します。.
コストとトークン効率:Opus 4.7 がなぜ大幅に高価なのか
Opus 4.7とOpus 4.6の最も顕著な違いの一つは、コスト効率です。.
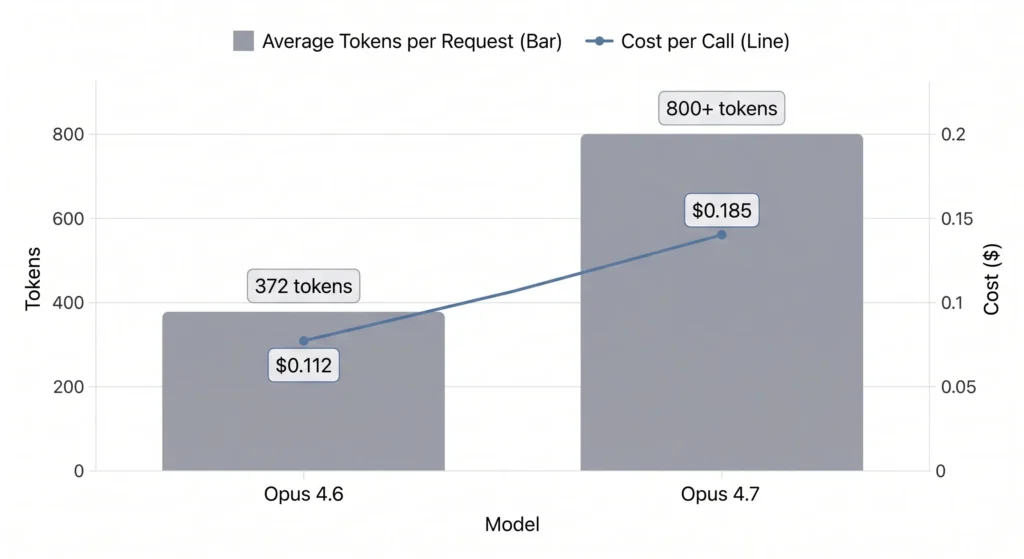
数千件のAPI呼び出し全体において:
- リクエストあたりの平均トークン数:
- 4.6: 372
- 4.7: 800+
- 1件あたりの通話料金:
- 4.6: $0.112
- 4.7: $0.185 (+65%)
この増加は単なる理論上の話ではなく、実際の利用においては急速に増幅していきます。.
コスト上昇の要因は何なのか?
- 詳細度を上げる
回答は著しく長くなっており、しばしば冗長な論拠が含まれている。. - さらに再試行が必要です
出力の失敗は追加の呼び出しにつながり、コストが倍増します。. - 信号密度の低下
トークンの数が多いからといって、必ずしもより良い回答が得られるとは限りません。.
本番環境では、これにより明確なトレードオフが生じます:
Opus 4.7は理論上はより高性能かもしれませんが、Opus 4.6の方が成功1件あたりのコストパフォーマンスに優れています。.
信頼性と反復開発:Opus 4.6 が開発ワークフローにおいて優れている理由
単純な成功率だけでなく、反復にかかるコストも生産性を左右する大きな要因です。.
測定された再試行率:
- 4.6: タスクあたり0.22回の再試行
- 4.7: タスクあたり0.46回の再試行(約2倍)
これには連鎖的な影響があります:
- ワークフローのさらなる中断
- 認知負荷の増加
- 複数のターンにわたるコンテキストの劣化
実際のワークフローへの影響
以前(作品4.6):
- 初回で実用可能な結果が得られる可能性が高い
- 補正サイクルの最小化
『アフター』(作品4.7):
- プロンプトを微調整する必要がより頻繁に生じる
- 出力の一部が欠落したり、誤った結果が出たりする可能性が高くなります
- 双方向のやり取りの増加
結果は明らかです:
ワンショット精度がわずかに低下しただけでも、全体的な生産性は大幅に低下します。.
事例研究:3日間の並行コーディング評価
セットアップ
- 環境:実環境での開発タスク(合成ベンチマークではない)
- 所要時間:
- Opus 4.7:3,592件の呼び出し(3日間)
- Opus 4.6:8,020件の呼び出し(8日間)
- ツール:Claude Code + codeburn analytics
主要指標の比較
| メートル法 | 作品4.6 | 作品番号 4.7 |
|---|---|---|
| 一発成功 | 83.8% | 74.5% |
| コーディングの成功 | 84.7% | 75.4% |
| デバッグの成功 | 85.3% | 76.5% |
| タスクごとの再試行回数 | 0.22 | 0.46 |
| 1回の呼び出しあたりのトークン数 | 372 | 800+ |
| 1件あたりの通話単価 | $0.112 | $0.185 |
重要な洞察
このデータセットからは、以下のことがわかります:
- パフォーマンスの低下は、単なる噂話ではなく、測定可能なものである
- コストは上昇する一方で、成功率は低下している
- 反復処理のオーバーヘッドが、隠れたボトルネックとなる
ケーススタディ:機能開発とデバッグのパフォーマンス比較
興味深いことに、すべてのタスクで退行が見られるわけではない。.
機能開発中:
- 作品4.6: 71.4% 成功
- 作品4.7: 75%の成功
サンプル数は少ないものの、このことは以下のことを示唆している:
- Opus 4.7 は、以下の環境でより良好なパフォーマンスを発揮する可能性があります:
- 自由課題
- 探索的コーディング
- 創造的な問題解決
しかし、次のような課題に直面している:
- 決定論的デバッグ
- 高精度を要する論理
- 厳格な正しさの要件
通訳
Opus 4.7 は、以下の用途向けに最適化されているようです。 探査, 一方、作品4.6は依然として……においてより力強い 実行.
事例研究:ツールの使用状況とエージェントの行動
もう1つの予想外の結果は、ツールの利用や業務の委任が減少しているという点である:
- 1ターンあたりのツール数:
- 4.6: 2.77
- 4.7: 1.83
- 委任率:
- 4.6: 3.1%
- 4.7: 0.6%
なぜこれが重要なのか
現代のAIワークフローは、以下の要素に依存しています:
- ツールの呼び出し
- 多段階の推論
- サブエージェントへの権限委譲
利用の減少は、以下のことを示唆しています:
- 問題の分解を少なくする
- さらに一様的な反応
- システムレベルの効率の低下
これは、以下の点を部分的に説明しているのかもしれません:
- 説明の詳しさの向上
- 成功率の低下
- リトライ回数の増加
プロンプトの感度:Opus 4.7 で再最適化が必要な理由
一連のテストを通じて一貫して見られた結果は、Opus 4.7の方がより文字通りの動作をするという点です。.
主な相違点
作品4.6:
- ユーザーの意図を推測する
- 不足している詳細を補完する
- 曖昧な指示に対してもより柔軟に対応できる
作品4.7:
- 指示の厳格な遵守
- 暗黙的な推論を減らす
- 高度に構造化されたプロンプトが必要
実務上の影響
4.7 への移行を行うチームは、以下の課題に直面します:
- プロンプトの再設計にかかる費用
- システムプロンプトの書き換え
- パイプラインの再調整
こうした調整を行わないと、パフォーマンスが実際よりも悪く見えてしまう可能性があります。.
創造性と正確性:4.7と4.6の間のトレードオフ
使用状況全体に見られるもう一つの傾向:
- 作品4.6:
- より直感的
- ブレインストーミングには適している
- より強い「クリエイティブな雰囲気」“
- 作品4.7:
- より剛性が高い
- より体系的な
- 文体のばらつきが少ない
これにより、明らかなトレードオフが生じます:
| ユースケース | より優れたモデル |
|---|---|
| 創作 | 4.6 |
| ブレインストーミング | 4.6 |
| 構造化パイプライン | 4.7 |
| 自由な探求 | 4.7 |
Opus 4.7 と Opus 4.6、それぞれいつ使うべきか?
次のような機能が必要な場合は、Opus 4.6 を選択してください:
- 高いワンショット精度
- タスクあたりのコストを削減
- 確実なデバッグ
- 最小限のプロンプトエンジニアリング
次のような用途には、「Opus 4.7」をお選びください:
- 複雑で多段階にわたる推論
- 自由形式の生成
- 指示の厳格な遵守
- パイプライン制御
よくある質問:Opus 4.7 と Opus 4.6 の比較
Opus 4.7は、Opus 4.6よりも実際に優れているのでしょうか?
一貫してそうとは限りません。一部の自由度の高いタスクでは優れたパフォーマンスを発揮しますが、コーディングの信頼性やコスト効率の面では期待通りの成果が得られていません。.
Opus 4.7 では、なぜより多くのトークンが使われているのですか?
これにより、より長く、より詳細な応答が生成され、再試行回数も増えることが多く、その両方がトークンの総使用量を増加させます。.
Opus 4.7の方が幻聴がひどくなるのでしょうか?
精度が重視されるタスク(数値的推論など)では、実際のワークフローにおける4.6と比較して、より多くの誤りが生じることが示されている。.
Opus 4.6 から 4.7 にアップデートしたほうがいいでしょうか?
以下の条件を満たす場合に限り:
- プロンプトの再最適化
- コスト増を受け入れる
- 信頼性を犠牲にして柔軟性を優先する
Opus 4.7はなぜより「硬い」と感じられるのでしょうか?
指示をより文字通りに忠実に実行し、文脈の抜けを推測しようとする傾向が弱いため、直感的に感じられにくい。.
ベンチマークのパフォーマンスは誤解を招くものなのでしょうか?
はい。ベンチマークでのパフォーマンス向上は、必ずしも実際の生産性を反映しているとは限りません。特に反復的なワークフローにおいてはそうです。.
Opus 4.7 では、なぜリトライ回数が増えているのですか?
ワンショットの精度が低いと、補正サイクルが増え、再試行回数やコストが増加することになります。.
Opus 4.7の方がコーディングには向いていますか?
ほとんどのワークフローにおいて、現状のままだと不向きです。デバッグや決定論的なタスクでは、パフォーマンスが低下します。.
Opus 4.7 では新しいプロンプトが必要ですか?
はい。最適な結果を得るためには、より体系的で明確な指示が必要になることがよくあります。.
Opus 4.7は今も改良が進められているのでしょうか?
観察された動作から判断すると、その性能を最大限に引き出すには、さらなる調整と最適化が必要と思われる。.
最終的な結論
『Opus 4.7』は、より構造化され、指示に従うAIへの転換を象徴しているが、その転換にはトレードオフが伴う。.
今日の実際のワークフローのほとんどにおいて:
- Opus 4.6は、より効率的で、信頼性が高く、コストパフォーマンスに優れています
- Opus 4.7は、より実験的で柔軟性が高い反面、予測しにくくなっています
本当に重要なのは、どのモデルが「優れている」かということではなく、次の点です。
最適なモデルとは、ベンチマークで最高スコアを記録するモデルではなく、実際のワークフローにおける再試行回数、コスト、および手間を最小限に抑えられるモデルです。.