Risposta breve:
Opus 4.6 offre attualmente maggiore affidabilità, costi inferiori e migliori percentuali di successo al primo tentativo nei flussi di lavoro di codifica reali, mentre Opus 4.7 mostra un potenziale nelle attività aperte, ma richiede ulteriori messa a punto, budget di token più elevati e un maggior numero di tentativi per ottenere risultati simili.
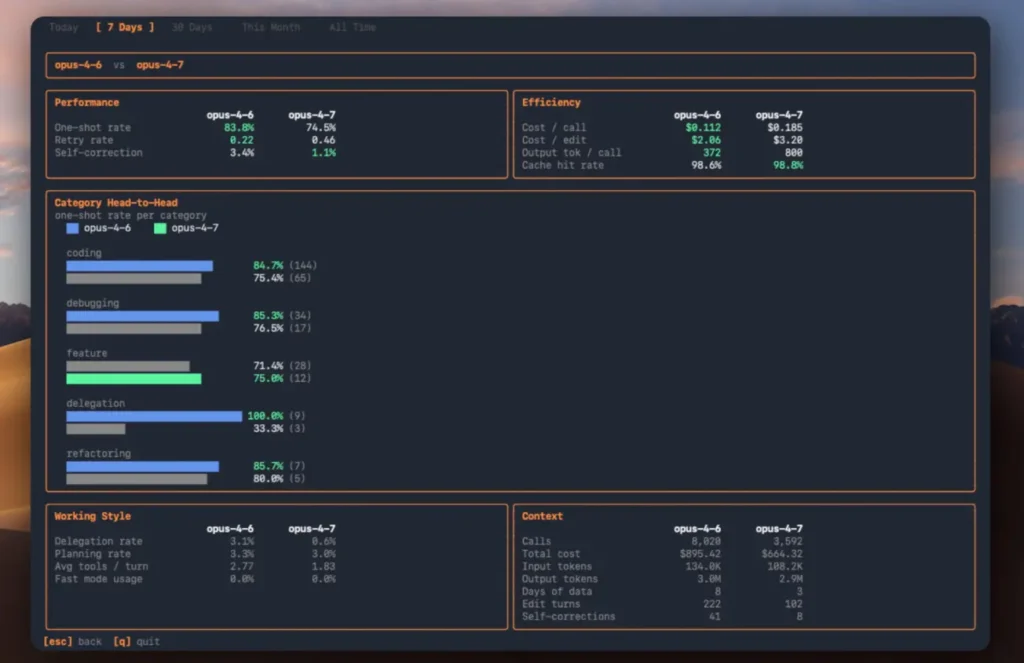
Opus 4.7 vs Opus 4.6: prestazioni reali vs benchmark
La maggior parte dei confronti tra Opus 4.7 e Opus 4.6 si basano su test di benchmark controllati. Tuttavia, quando vengono valutati nell'ambito di flussi di lavoro di sviluppo reali nell'arco di diversi giorni, emerge un quadro diverso.
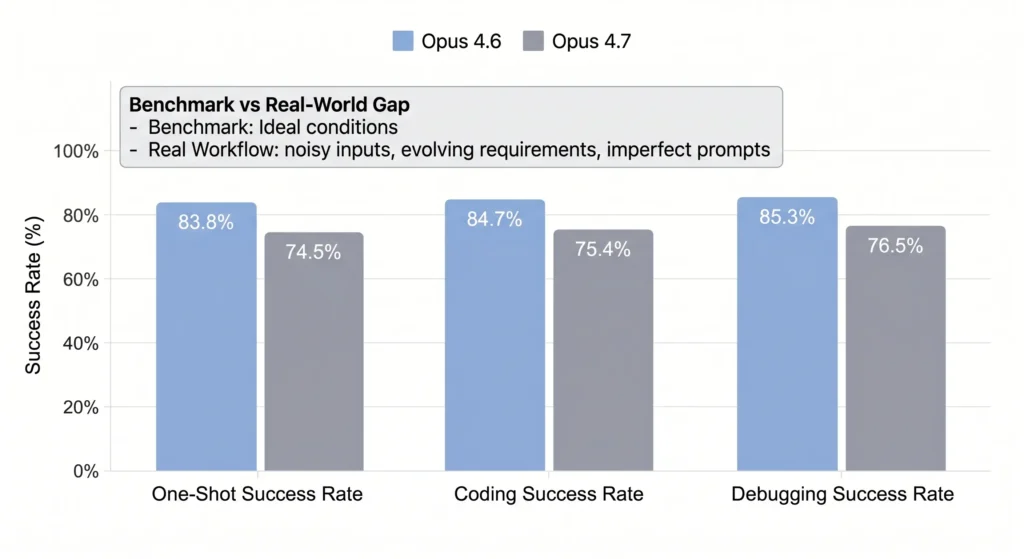
In una valutazione comparativa della durata di più giorni, condotta su migliaia di interazioni di programmazione reali:
- Opus 4.6 completato 83,81 TP3T: tasso di successo in un unico tentativo
- Opus 4.7 è sceso a 74.5%
- Il tasso di successo nel debug è sceso da 85,31 TP3T → 76,51 TP3T
- Il tasso di successo nelle attività di programmazione è sceso da 84,71 TP3T → 75,41 TP3T
Questo divario mette in luce una distinzione fondamentale:
I miglioramenti nei test di riferimento non si traducono necessariamente in maggiore efficienza produttiva.
Nella pratica, i flussi di lavoro reali comportano elementi di disturbo: contesti parziali, requisiti in continua evoluzione e istruzioni imperfette. In queste condizioni, Opus 4.6 si dimostra più tollerante e affidabile.
Costo ed efficienza dei token: perché Opus 4.7 è notevolmente più costoso
Una delle differenze più evidenti tra Opus 4.7 e Opus 4.6 è il rapporto costo-efficacia.
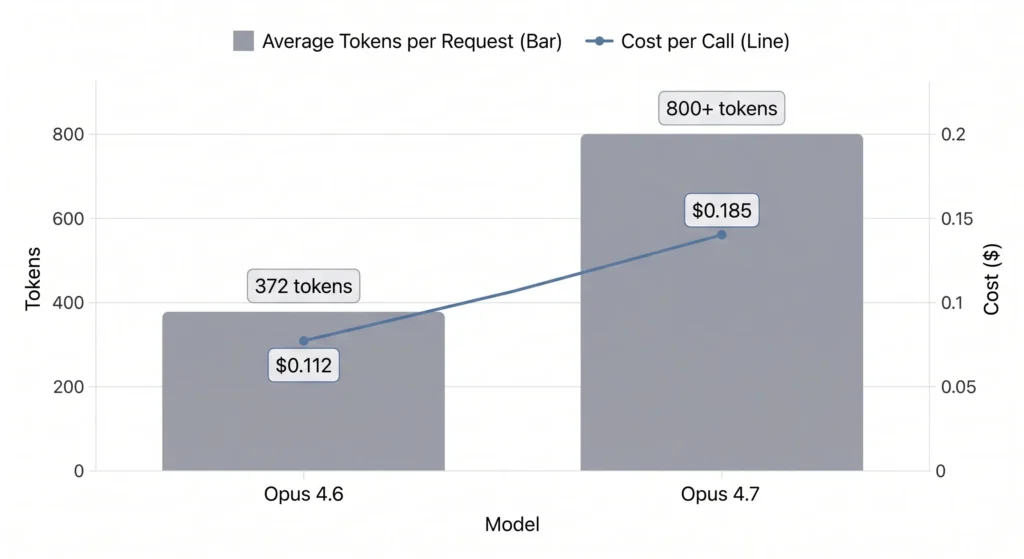
In migliaia di chiamate API:
- Numero medio di token per richiesta:
- 4.6: 372
- 4.7: 800+
- Costo per chiamata:
- 4.6: $0.112
- 4.7: $0.185 (+65%)
Questo aumento non è solo teorico: nell’uso pratico si accumula rapidamente.
Cosa sta determinando l'aumento dei costi?
- Maggiore livello di dettaglio
Le risposte sono notevolmente più lunghe e spesso contengono ragionamenti ridondanti. - Sono necessari ulteriori tentativi
I risultati insoddisfacenti comportano ulteriori richieste, con un conseguente aumento dei costi. - Minore densità del segnale
Un numero maggiore di token non significa necessariamente risposte migliori.
Negli ambienti di produzione, ciò comporta un evidente compromesso:
Opus 4.7 potrà anche essere più performante in teoria, ma Opus 4.6 risulta più conveniente in termini di costo per risultato positivo.
Affidabilità e iterazione: perché Opus 4.6 è la scelta vincente nei flussi di lavoro degli sviluppatori
Al di là dei semplici tassi di successo, il costo delle iterazioni è un fattore determinante per la produttività.
Tassi di riprova rilevati:
- 4.6: 0,22 tentativi di ripetizione per attività
- 4.7: 0,46 tentativi di ripetizione per attività (circa il doppio)
Ciò comporta una serie di conseguenze a catena:
- Ulteriori interruzioni nel flusso di lavoro
- Aumento del carico cognitivo
- Deterioramento del contesto nel corso di più turni
Impatto effettivo sul flusso di lavoro
Prima (Opus 4.6):
- Elevata probabilità di ottenere un risultato utilizzabile al primo tentativo
- Cicli di correzione minimi
Dopo (Opus 4.7):
- Necessità più frequente di perfezionare i prompt
- Maggiore probabilità di risultati parziali o errati
- Maggiore interazione bidirezionale
Il risultato è chiaro:
anche piccoli cali nella precisione dei colpi singoli riducono in modo significativo la produttività complessiva.
Caso di studio: valutazione della programmazione in parallelo della durata di 3 giorni
Configurazione
- Ambiente: attività di sviluppo reali (non benchmark sintetici)
- Durata:
- Opus 4.7: 3.592 chiamate (3 giorni)
- Opus 4.6: 8.020 chiamate (8 giorni)
- Strumenti: Claude Code + Codeburn Analytics
Confronto tra gli indicatori chiave
| Metrico | Opus 4.6 | Opus 4.7 |
|---|---|---|
| Successo immediato | 83.8% | 74.5% |
| Il successo nella programmazione | 84.7% | 75.4% |
| Debug riuscito | 85.3% | 76.5% |
| Numero di tentativi per attività | 0.22 | 0.46 |
| Token per chiamata | 372 | 800+ |
| Costo per chiamata | $0.112 | $0.185 |
Approfondimento chiave
Questo set di dati mostra che:
- Il calo delle prestazioni è misurabile, non aneddotico
- I costi aumentano mentre i tassi di successo diminuiscono
- Il sovraccarico dovuto alle iterazioni diventa il collo di bottiglia nascosto
Caso di studio: Sviluppo delle funzionalità vs prestazioni di debug
È interessante notare che non tutte le attività mostrano un peggioramento.
In fase di sviluppo delle funzionalità:
- Opus 4.6: 71,41 TP3T: successo
- Opus 4.7: Successo del modello 75%
Sebbene si basi su un campione più ristretto, ciò suggerisce che:
- Opus 4.7 potrebbe offrire prestazioni migliori nei seguenti ambiti:
- Compiti a risposta aperta
- Codifica esplorativa
- Risoluzione creativa dei problemi
Ma ha difficoltà con:
- Debug deterministico
- Logica ad alta precisione
- Requisiti rigorosi di correttezza
Interpretazione
Opus 4.7 sembra ottimizzato per esplorazione, mentre l'Opus 4.6 rimane più potente per esecuzione.
Caso di studio: utilizzo degli strumenti e comportamento degli agenti
Un altro dato inaspettato è il calo nell'uso degli strumenti e nella delega:
- Strumenti per turno:
- 4.6: 2.77
- 4.7: 1.83
- Tasso di delega:
- 4.6: 3.1%
- 4.7: 0.6%
Perché è importante
I moderni flussi di lavoro basati sull'intelligenza artificiale si basano su:
- Chiamata di strumenti
- Ragionamento in più fasi
- Delega a un subagente
Un utilizzo ridotto suggerisce che:
- Meno scomposizione dei problemi
- Risposte più monolitiche
- Minore efficienza a livello di sistema
Questo potrebbe spiegare in parte:
- Maggiore verbosità
- Tassi di successo inferiori
- Numero maggiore di tentativi
Sensibilità ai prompt: perché Opus 4.7 richiede una nuova ottimizzazione
Un risultato che emerge costantemente dai test è che Opus 4.7 si comporta in modo più fedele all’originale.
Differenze principali
Opus 4.6:
- Deduce l'intento dell'utente
- Completa i dettagli mancanti
- Più tollerante nei confronti di istruzioni vaghe
Opus 4.7:
- Rigoroso rispetto delle istruzioni
- Ragionamento meno implicito
- Richiede istruzioni altamente strutturate
Impatto pratico
I team che effettuano la migrazione alla versione 4.7 si trovano ad affrontare:
- Costi di riprogettazione del prompt
- Riscrittura dei messaggi di sistema
- Ricalibrazione della pipeline
Senza queste rettifiche, le prestazioni potrebbero risultare peggiori di quanto non siano in realtà.
Creatività contro precisione: compromessi tra 4.7 e 4.6
Un altro modello osservato nell'ambito dell'utilizzo:
- Opus 4.6:
- Più intuitivo
- Ideale per il brainstorming
- Un “tocco creativo” più marcato”
- Opus 4.7:
- Più rigido
- Più strutturato
- Minore varietà stilistica
Ciò comporta un evidente compromesso:
| Caso d'uso | Modello migliore |
|---|---|
| Scrittura creativa | 4.6 |
| Brainstorming | 4.6 |
| Pipeline strutturate | 4.7 |
| Esplorazione senza limiti | 4.7 |
Quando è meglio usare Opus 4.7 invece di Opus 4.6?
Scegli Opus 4.6 se hai bisogno di:
- Elevata precisione in un unico colpo
- Costo inferiore per attività
- Debug affidabile
- Ingegneria minimale dei prompt
Scegli Opus 4.7 se hai bisogno di:
- Ragionamento complesso in più fasi
- Generazione a tempo indeterminato
- Rigoroso rispetto delle istruzioni
- Controllo delle condotte
Domande frequenti: Opus 4.7 vs Opus 4.6
Opus 4.7 è davvero migliore di Opus 4.6?
Non sempre. Offre prestazioni migliori in alcune attività aperte, ma risulta meno efficace in termini di affidabilità della codifica ed efficienza in termini di costi.
Perché Opus 4.7 utilizza un numero maggiore di token?
Genera risposte più lunghe e dettagliate e spesso richiede un maggior numero di tentativi, il che comporta un aumento del consumo totale di token.
Opus 4.7 ha più allucinazioni?
Nelle attività che richiedono precisione (come il ragionamento numerico), presenta un numero di errori superiore rispetto a 4,6 nei flussi di lavoro reali.
Dovrei passare da Opus 4.6 a 4.7?
Solo se sei disposto a:
- Ottimizzare nuovamente i prompt
- Accettare costi più elevati
- Preferire la flessibilità all'affidabilità
Perché Opus 4.7 sembra più “rigido”?
Segue le istruzioni in modo più letterale ed è meno incline a dedurre il contesto mancante, il che lo rende meno intuitivo.
I risultati dei benchmark sono fuorvianti?
Sì. I miglioramenti rispetto ai benchmark non riflettono sempre la produttività effettiva, specialmente nei flussi di lavoro iterativi.
Perché in Opus 4.7 il numero di tentativi è più elevato?
Una minore precisione dei comandi a impulso singolo comporta un maggior numero di cicli di correzione, con un conseguente aumento dei tentativi e dei costi.
Opus 4.7 è migliore per la programmazione?
Non nella sua forma attuale, per la maggior parte dei flussi di lavoro. Le sue prestazioni sono inferiori nelle attività di debug e in quelle deterministiche.
Opus 4.7 richiede nuovi prompt?
Sì. Spesso sono necessari prompt più strutturati ed espliciti per ottenere risultati ottimali.
Opus 4.7 continua a migliorare?
Sulla base del comportamento osservato, è probabile che siano necessarie ulteriori messe a punto e ottimizzazioni per sfruttarne appieno il potenziale.
Verdetto finale
Opus 4.7 segna una svolta verso un'intelligenza artificiale più strutturata e orientata all'esecuzione di istruzioni, ma tale svolta comporta alcuni compromessi.
Per la maggior parte dei flussi di lavoro reali odierni:
- Opus 4.6 è più efficiente, affidabile e conveniente
- Opus 4.7 è più sperimentale, flessibile, ma meno prevedibile
Il vero insegnamento da trarne non è quale modello sia “migliore”, ma questo:
Il modello migliore è quello che riduce al minimo i tentativi ripetuti, i costi e gli ostacoli nel flusso di lavoro effettivo, non quello che ottiene il punteggio più alto nei test di benchmark.